免责声明
本文由 LLM 参与创作。内容仅供学习研究与授权环境中的安全分析,请勿对未授权系统开展测试。文中利用机制均来自已公开的安全研究与官方通告,代码片段为简化示意。
0x00 引言:那一晚,半个互联网同时熄灯
2026 年 10 月 21 日,周三。下面所有时间都是北京时间。
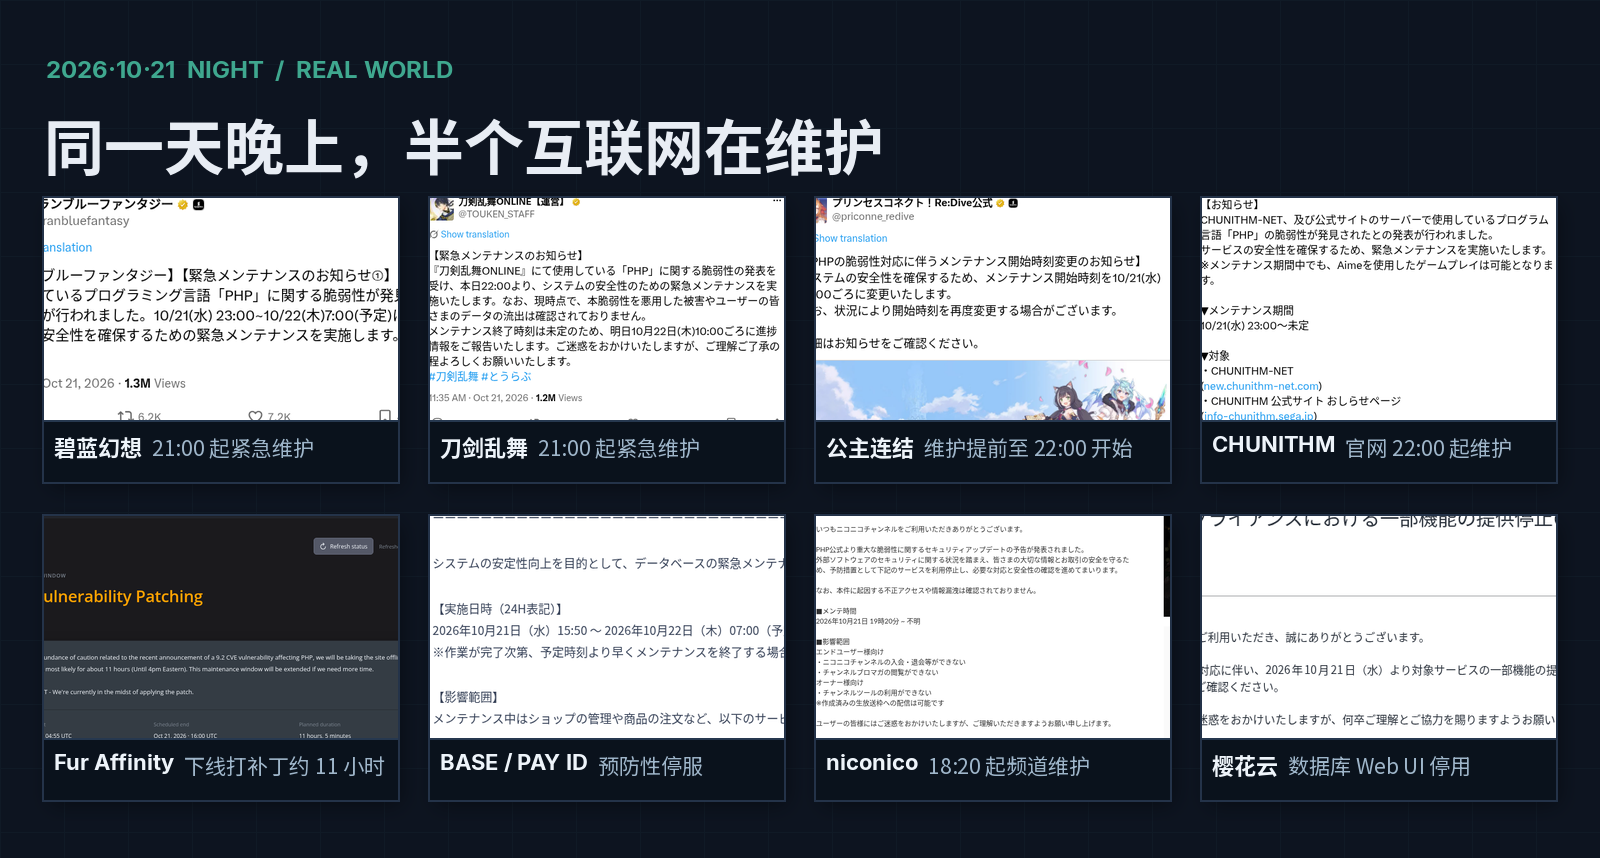
从下午开始,日本一批游戏厂商的公告栏里陆续出现同一句措辞——「本サービスで使用している PHP に関する脆弱性が発見された」(本服务所使用的 PHP 被发现存在漏洞)。这些公告的发布时间惊人地集中:18:20,niconico 的频道功能先进入维护;19:00,Bandai Channel 全站暂停;21:00 前后,赛马娘、碧蓝幻想、公主连结、刀剑乱舞、文豪与炼金术师几乎同时宣布紧急维护;22:00,中二节奏的官网和 CHUNITHM-NET 也跟上了。
它们分属不同的公司、不同的业务,公告却指向同一个原因:PHP。
到午夜零点,能核实到的名单已经长到需要拉一张表——至少 17 家服务因这两个漏洞进入维护或暂停部分功能:至少 9 款游戏及其相关服务、至少 8 组平台与厂商服务,横跨日本、美国、欧洲。停摆的程度各不相同:有的只关了管理后台,网站照常访问;有的整站下线;还有像樱花云那样,把数据库的 Web 图形界面(phpMyAdmin 那一类)单独摘掉。这只是当晚零点前能确认的部分。
比停服更值得注意的是另一件事。当晚 20:55,日本首相高市早苗在 X 上发了一条推文,标题是「皆様に、今夜に対応して頂きたい大至急のお願いです」——「今晚恳请大家立即应对的紧急请求」。
国家首脑为一个编程语言的漏洞亲自喊话,这在此前几乎没有先例。她没有停在「请注意安全」这种层面,而是给了非常具体的指令:确认自己的网站是否在用 PHP;当晚 23:00(日本时间)补丁发布后第一时间应用;如果实在来不及打补丁,「暂时关闭网站」也是降低风险的有效手段之一。
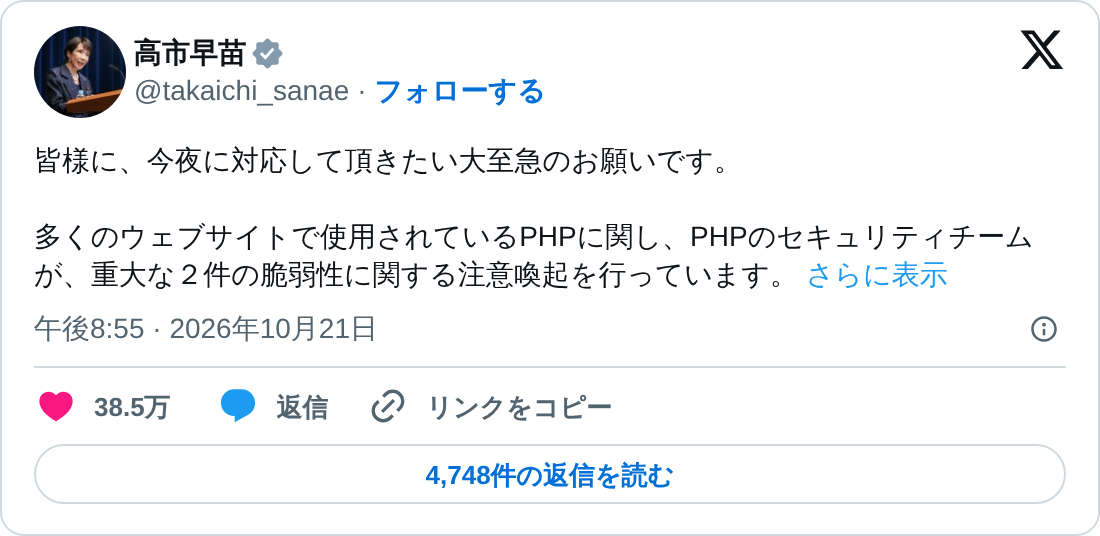
高市早苗:皆様に、今夜に対応して頂きたい大至急のお願いです,发布于北京时间 21 日 20:55。
补丁确实在一小时后发布了。而这一小时的窗口里,是什么让一个国家的首相都要出来喊话?原因写在 PHP 官方当天发布的安全公告里。
PHP 紧急发布 8.5.12 / 8.4.27 / 8.3.36 / 8.2.35,修复两个 CVSS 4.0 均为 9.2 的未认证远程代码执行漏洞:CVE-2026-109618(OOM corruption)和 CVE-2026-109619(stale global state)。社区把这组漏洞称为 PHP2Shell。
CVSS 9.2 是这个量表上的次高档。翻译成人话:不需要账号、不需要受害用户点任何东西、不需要任何前置条件,一个 HTTP 请求就能在服务器上执行任意命令。而 PHP 是 WordPress、Drupal、Joomla、Magento、Nextcloud 这些建站系统共同的底座——按 W3Techs 的统计,在服务端语言已知的网站里它占了七成以上。这就解释了当晚的连锁反应:修复必须换掉运行中的 PHP 进程,而大多数公司没把握在不停机的情况下安全完成,于是只能选择先停下来。
需要说清楚的边界:停服维护不等于已经被入侵。 绝大多数厂商是预防性下线,公告里也普遍写明「目前尚未确认有非法访问或信息泄露」。本文关心的不是当晚谁停了服,而是漏洞本身。
那么问题来了:到底是什么样的漏洞,能让「重启一下 PHP」都变成一件需要赌运气的事?
答案有点反直觉——它跟业务代码怎么写几乎无关。下面这段 PHP,没有数据库、没有文件上传、没有调 session_start(),业务逻辑只有一行输出:
<?php
echo "OK\n";
但在公开的利用实现里,它就是标准的攻击目标——纯 HTTP 打进去,拿到 uid=33(www-data) 的命令执行。
秘密全在 echo 的前后。PHP 处理一个请求,得先把输入解析好、把运行环境初始化好,结束后还要做一遍请求清理,业务代码只占中间一小段。这两个 CVE 恰好埋在准备和收尾这两步里:内存耗尽(OOM)本来是最普通的故障,但在特定的时序下,它变成了攻击者手里的一个开关。
要理解这个开关怎么用,得先知道 PHP 在跑业务代码之前,到底做了什么。
先补一点背景:上传一个文件,PHP 到底做了什么?
平时上传头像、提交附件,页面上看起来只有“选择文件”和“提交”两个动作。服务器实际要先拆开整个请求,分清哪些是普通文字、哪些是文件,再为业务代码准备数据。PHP2Shell 涉及的几个关键环节,就藏在这段准备工作和之后的清理工作里。
第一步:浏览器把表单编码成 multipart。 一个普通的上传表单大致如下。这只是正常上传功能的示例:
<form action="upload.php" method="post" enctype="multipart/form-data">
  <input type="text" name="description" value="旅行照片">
  <input type="file" name="photo">
  <button type="submit">上传</button>
</form>
multipart/form-data 可以理解为“一个包裹里装了多个小包”。浏览器用 boundary 分隔各个 part;每个 part 的头部说明字段名,文件 part 还带文件名等信息,后面接实际内容。上面的请求包含两部分:description 的文字,以及 photo 的文件数据。这里的 part 指请求体中的一个分段,和一次新的 HTTP 请求是两回事。
第二步:Web 服务器把请求交给 PHP。 常见部署有两种。一种是 Apache 的 mod_php,PHP 直接嵌在 Apache 进程里跑;另一种是 PHP-FPM,它自己维护一批 PHP 工作进程,由 Nginx 或 Apache 通过 FastCGI 把请求转过去。
这一层接口叫 SAPI(Server API);真正处理请求的工作进程则叫 worker,一个 worker 通常要接连处理很多个请求。
Web 服务器还可能先缓冲请求体,再交给 PHP。因此“浏览器正在上传”和“PHP 正在解析上传数据”这两个时间段,具体如何重叠取决于部署配置。
第三步:PHP 解析请求,建立业务代码能直接读取的数据。 在开启自动 POST 解析的常见配置下,PHP 会在执行目标脚本之前处理适用的 POST 请求体。multipart 解析器逐段读取输入:普通字段进入 $_POST;文件内容通常写入上传临时文件;文件的名称、大小、临时路径和上传状态则记录到 $_FILES。
浏览器提交 multipart 请求
  └─ Web 服务器交给 PHP
      └─ PHP 解析请求体
          ├─ 普通字段 → $_POST['description']
          ├─ 文件内容 → 服务器上的上传临时文件
          └─ 文件信息 → $_FILES['photo']
      └─ 执行 upload.php
          └─ 业务校验后,再决定是否保存文件
└─ 请求收尾:清理本次请求的数据和剩余临时文件$_POST、$_FILES 属于 PHP 的“超全局变量”,脚本可以直接读取。以上面这个表单为例,$_FILES['photo'] 里的关键字段包括:
name:客户端提供的原始文件名。tmp_name:服务器保存上传内容的临时路径。size、error:文件大小和上传结果。type:客户端提供的 MIME 类型,业务端仍需验证实际内容。full_path:客户端提交的路径信息,PHP 8.1 起提供,同样需要按不可信输入处理。
此时文件还只是被临时接收。业务代码接下来检查身份权限、错误码、大小和实际文件类型,再用 move_uploaded_file() 等操作保存到选定位置。正常请求结束时,未移走的上传临时文件会被清理。接收与解析发生在前,应用决定接受或拒绝发生在后。 具体字段与处理流程可以对照 PHP 官方文件上传手册。
文件放在临时目录,为什么还会牵涉内存?
文件内容虽然写进了临时文件,PHP 还是得在内存里维护解析缓冲、字段名、字段值,以及描述这些文件的数组。$_FILES 存的是文件信息,文件正文一般留在临时文件里。
PHP 数组在内核里主要由 HashTable(哈希表) 实现,里面每个元素槽位叫 Bucket,值用 zval 表示。可以先把它们理解成“目录”“目录里的一条记录”“这条记录存的值”。每条记录除了用户提交的文字,还带着类型、长度、引用计数这些管理信息。所以要记住:请求体有多大、文件有多大、PHP 实际占了多少内存,这是三个不同的数字。
几个常见配置各管一摊:upload_max_filesize 管单个上传文件的大小,post_max_size 管整个 POST 请求体,memory_limit 管 PHP 分配器能用多少内存。
后面会说到 OOM(Out Of Memory),指的是内存分配按原有方式继续不下去了。要留意,触发 PHP 的内存上限时,整台服务器往往还有大量空闲内存。
上传进度条,为什么又和 session 有关系?
上传大文件时,页面需要知道“已经处理了多少字节”。PHP 的 Session Upload Progress 功能可以在解析上传数据的过程中,把进度写入 session,让另一个查询请求读取。
session 可以理解为服务器保存的一份会话数据,浏览器通常通过 cookie 中的会话标识找到它。除了登录状态,它也可以存放上传进度等临时信息。当上传进度功能开启、请求携带相应标记并满足处理条件时,PHP 会在上传解析阶段更新这些数据。
这里最该记住的是 官方手册的提醒:上传进度信息会在任何脚本执行之前就写进 session。
所以要把两件事分开看:目标脚本里有没有写 session_start(),是一回事;PHP 内核有没有已经碰过 session 状态,是另一回事。
这也回答了开头那个问题:即使页面只写了一行 echo,只要请求被交给 PHP 且相应解析功能启用,PHP 仍会先完成自己的准备工作。页面上有没有上传按钮,由前端决定;服务端解析哪种请求,由实际收到的请求和运行配置决定。
请求结束了,worker 为什么还在?
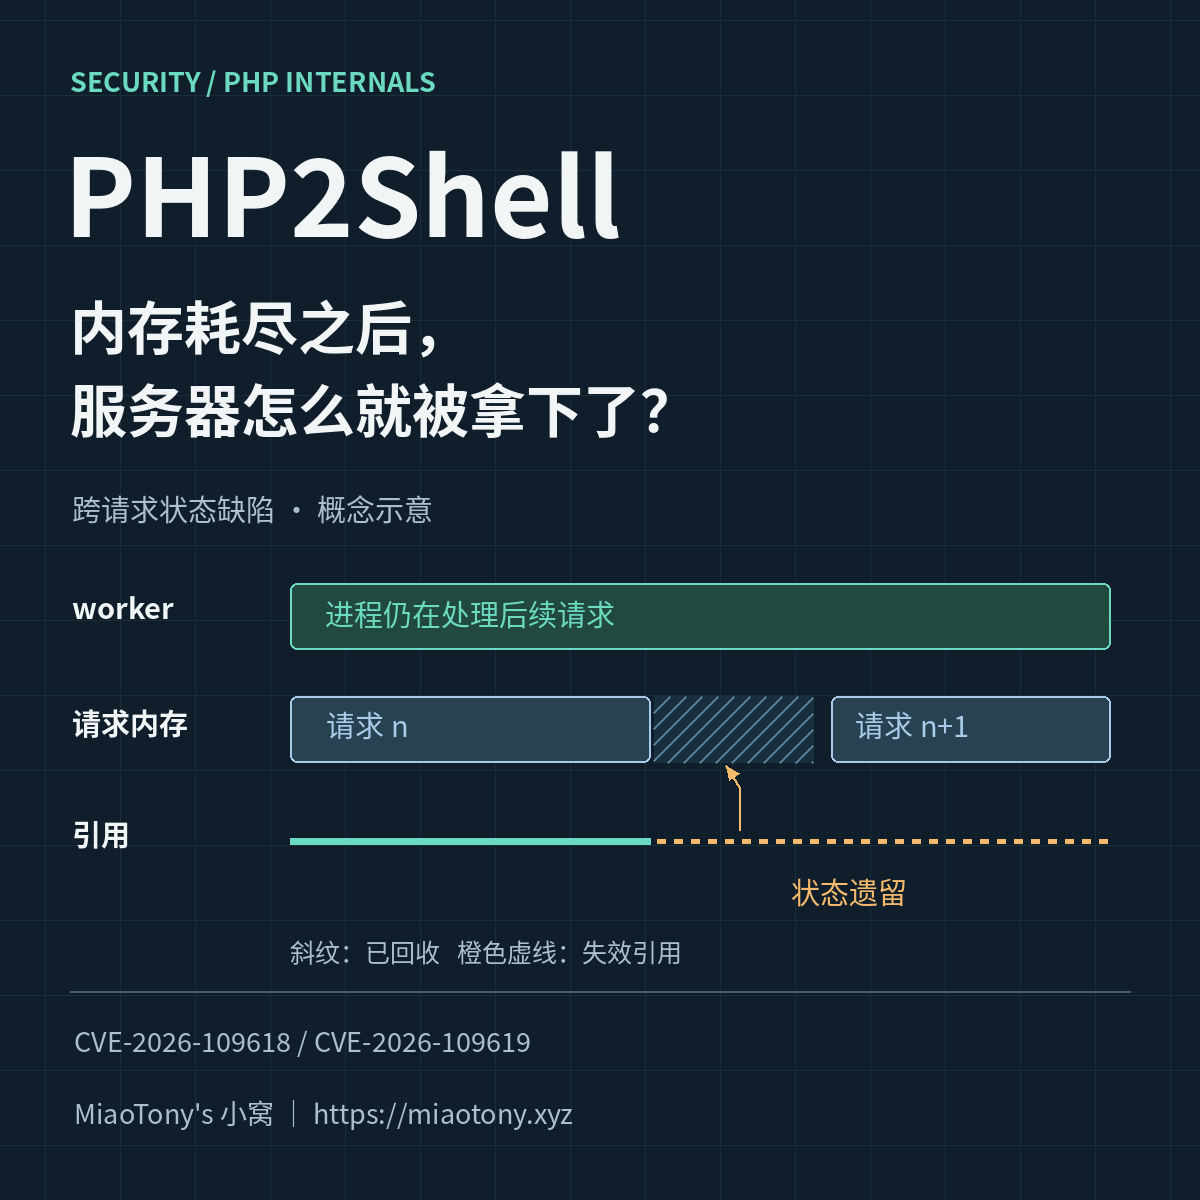
为了省下重复启动的开销,worker 通常会被复用,但本次请求分配的内存会在请求收尾时整体释放。于是就出现了两种不同的寿命:工作进程可以活过很多个请求,请求内存却只属于当前这一个请求。
进程里某个字段如果还存着已经释放的内存地址,它就是“悬空指针”。之后再有代码顺着它去访问原来的对象,就是 UAF(Use After Free,释放后使用)。
后面会用到几个术语。RINIT(request init,请求初始化)是每个请求开始时,扩展趁机为自己准备状态的那一步;RSHUTDOWN(request shutdown,请求结束处理)则是请求收尾时,扩展回头收拾自己的那一步。这一对对应着每个请求的头和尾,名字里的 R 就是 request。还有析构,指销毁一个值、顺手释放它占用的资源,通常在引用计数归零时自动发生。
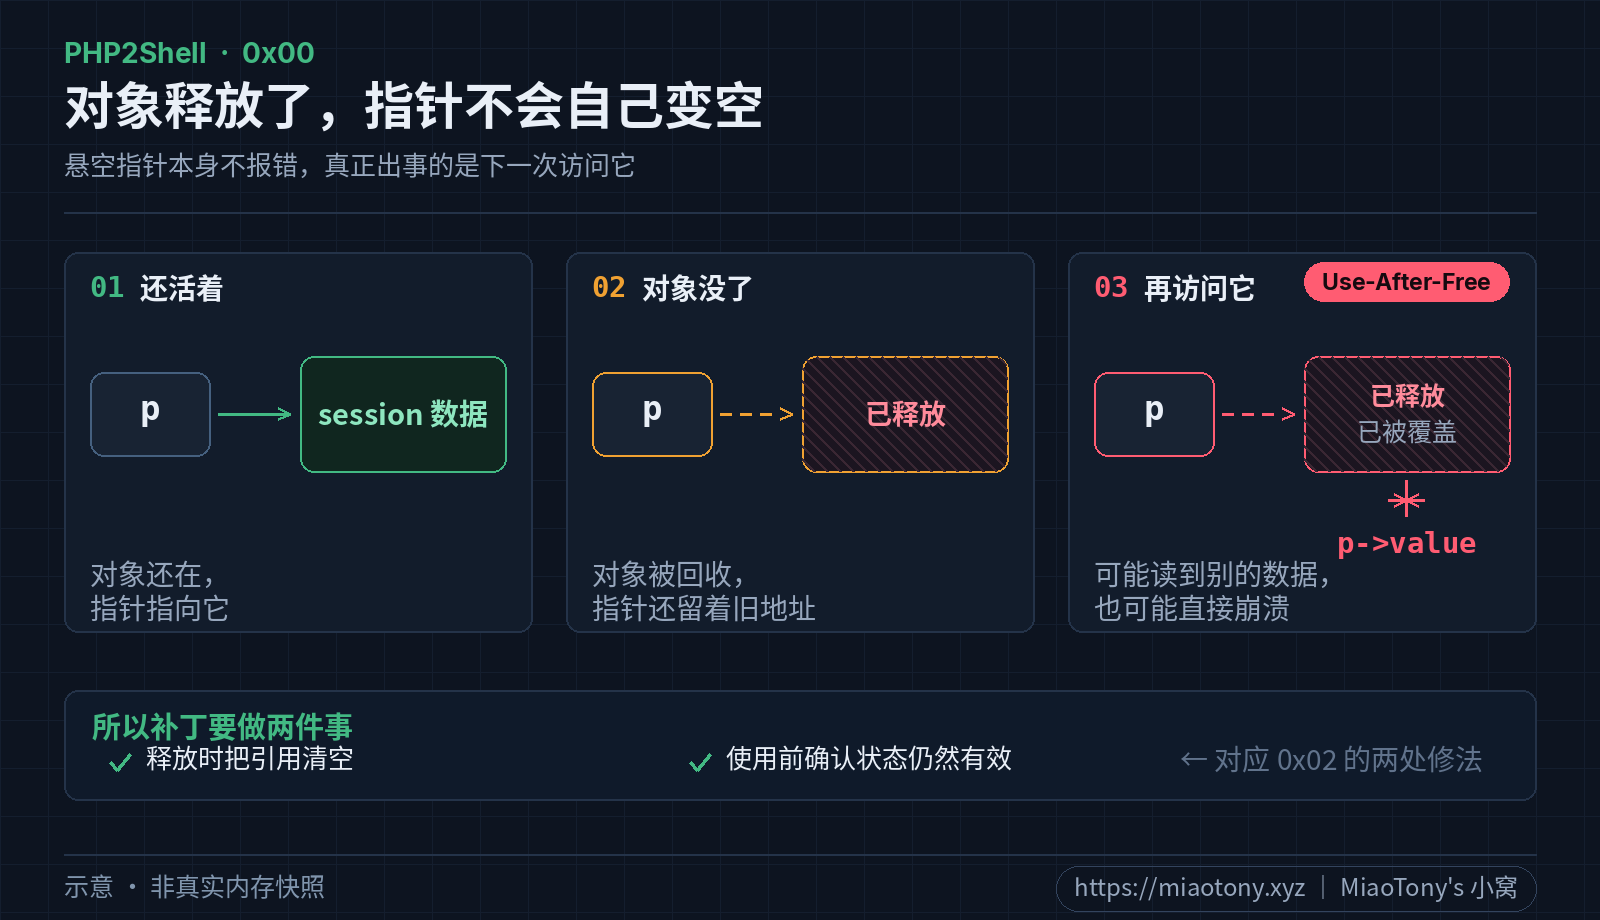
对象释放后,旧引用仍需撤销;访问前也要确认对象有效。
PHP 用引用计数来管理很多可共享数据的寿命。可以把它理解成“现在还有几个人在用这块数据”:释放一个值时计数减一,等最后一个使用者退场,底层的这块数据才具备回收条件。
这套机制的前提是计数和记录本身没错。一旦代码把无效内存误当成正常的值,连清理操作都会跟着读错记录——问题就从这里开始扩散。
另外还有两个容易混的词:序列化是把数组、对象这类数据转成便于保存或传输的形式,反序列化是把它们还原回来。
还原复杂数据时,PHP 要维护一份“还原进度”的上下文,里面记着已经处理过哪些值、彼此是什么引用关系、哪些对象还没清理。这份上下文自己也有初始化和销毁的过程——它的生命周期一旦出错,麻烦和业务数据出错是一样大的。
到这儿,背景就齐了。四件事连起来看:上传解析会建立数据结构,进度记录会提前接触 session,异常退出会改变清理顺序,而 worker 复用让部分错误状态有机会延续到后续请求。 它们各自都合理,凑在一起却构成了一条完整的攻击链。
不过在拆代码之前,还得先回答一个问题:这么基础的缺陷,为什么能活到今天?这就要说到一条长达二十年的伏笔。
0x01 漏洞披露:一条二十年长的伏笔
PHP2Shell 不是一个突然冒出来的新问题。把时间线拉长,它更像一条埋了二十年、一直没人踩到的线。
最早的伏笔在 2004 年。Stefan Esser 发现了 PHP 历史上第一个 memory-limit 远程漏洞——内存耗尽带来的不只是 500 错误,还可能被利用。这个 exploit 他从未公开,此后二十年,内存耗尽在大多数开发者心里始终只是个「要么调大 memory_limit、要么优化代码」的运维问题。
2020 年,bug #78876 报了一个看起来很边缘的问题:multipart 请求里的长变量可以导致 OOM,而且失败后临时文件不会被清理。报告提交了,但没有被当成安全问题深入追下去。
2024 年,OSTIF 和 Quarkslab 对 PHP 做安全审计时,又碰到了同一片区域。他们确认了相关问题的存在,但没能证明「可以真正利用」,于是也就没有得到修复——这在当时是合理的判断:证明不了利用,优先级自然高不起来。
转折发生在 2026 年 8 月。安全研究团队 Calif 参加 OpenAI 的「Patch the Planet」项目,把目标定成了 PHP。他们没有从最新代码扫起,而是翻出这段历史,顺着二十年前那条线往回追。几天之内,他们找到了第一个 OOM-fatal 中断点,随后一路扩展,做出了针对 mod_php 和 PHP-FPM 的可靠利用。8 月 11 日提交给 PHP 官方,四天后的 8 月 15 日,PHP 官方确认 RCE PoC 有效。
从那天到补丁公开,中间隔了两个多月。2026 年 10 月 21 日,修复版本发布,两个编号同步披露:GHSA-w8hw-w9fx-j79w(CVE-2026-109618)与 GHSA-6wmf-4rv5-p3rp(CVE-2026-109619)。
官方确认的利用范围很关键:mod_php 在默认输入与内存限制、正常 prefork 多 worker 的配置下,已在业务代码运行之前就验证了完整 RCE——不需要目标应用有任何漏洞,只要它跑在 Apache + mod_php 上就够。实测覆盖 WordPress、Drupal、Joomla、Magento、phpMyAdmin、Nextcloud、Laravel 等;FPM 侧也有官方验证的 session 生命周期 RCE,但需要一个前提:应用里存在可达的解码操作。
Calif 把已发现的路径最早追溯到 PHP 5.4,修复覆盖 8.2–8.5,并另外放出了 7.4 / 8.0 / 8.1 的最小源码回补分支。一手研究见 Calif 的 PHP2Shell 研究。
二十年的伏笔,最后落在两处代码上。要理解它们为什么能成立,最直接的办法不是看漏洞代码,而是先看官方是怎么修的——修法会告诉你作者认为哪里出了问题。
0x02 先看 patch:PHP 怎么改掉“OOM 即跳转”
补丁很大,但核心只有一句话:让内存耗尽别再「半路跳走」。先看提交说明——8.4 分支的修复提交是 506e87fa(8.5 为 31c0ea7d),提交说明只有两行:
Avoid state corruption via bailout

- Replace bailout on OOM with UnwindExit
- Properly reset various globals that may be accessed during startup
完整 diff 的核验结果为:402 个文件、+11112 / −1032 行,横跨 Zend、session、序列化、几乎全部扩展和 OPcache。改动密度本身就说明问题:这是一类生命周期缺陷,散布在所有“发布状态 → 干可能失败的活 → 提交”的代码路径上。
软 OOM:从“立刻跳走”改成“先记账,到安全点再退”
先看问题的根源。旧的 Zend MM 一旦撞到 memory_limit,处理方式是 zend_error_noreturn() → zend_bailout(),一次 longjmp 直接甩出当前执行流。
只要这段 C 代码当时正在改某个内部结构——计数加了、指针还没写、或者反过来——这一跳,就再也没人回来把它改完。
这里的 Zend MM 是 PHP 内核自带的内存管理器。
平时调用函数,是一层层往下走、再一层层返回,每层都有机会收拾自己的烂摊子。longjmp 不讲这个规矩:它直接跳回事先存好的位置,中间那些没执行的语句、没跑的清理代码,统统作废。
打个比方,就是火警响了直接跳窗——人倒是跑了,可手头改到一半的账本还摊在桌上,没人知道它改到了哪一行。后面的代码读到这本账,只会一头雾水。PHP 的 bailout 就是借这套机制中止当前处理的。
补丁的思路很直接:既然“半途跳走”是问题所在,那就别跳了,改成“先记一笔,等手头这活儿干完,再从容退出”。这就是延迟 OOM 状态机:
typedef enum _zend_oom_state {
    ZEND_OOM_STATE_NONE = 0,
    ZEND_OOM_STATE_PENDING,
    ZEND_OOM_STATE_HANDLING,
    ZEND_OOM_STATE_HANDLED
} zend_oom_state;
触及软限时先记下错误信息并置 VM 中断标志,等执行器跑到安全检查点再统一处理:
EG(delayed_oom).filename = script_filename;
EG(delayed_oom).lineno   = script_lineno;
EG(delayed_oom).state    = ZEND_OOM_STATE_PENDING;
zend_atomic_bool_store_ex(&EG(vm_interrupt), true);这里解释两个词:VM 是执行 PHP 指令的虚拟机;执行帧(frame)则是它为每个正在执行的函数维护的记录,写着“跑到哪条指令了、手上有哪些参数和局部变量”。
补丁在有执行帧时调用 zend_throw_unwind_exit(),让执行器沿着一条受控的路径层层退出;没有执行帧时,处理逻辑仍然会在检查点调用 zend_bailout()。
“安全点”指的就是那些会主动检查延迟 OOM 的位置——通常是在两条 PHP 指令之间,此刻执行器手里没有半截没写完的结构。
把退出动作全部推迟到这些位置,就再不会出现“底层结构改到一半、人已经跑了”的局面。
配套还加了一组 femalloc 族的可失败分配接口:分配不到内存就返回 NULL,由调用方自己处理半成品,取代过去“失败即跳转”的假设。
硬 OOM:放弃常规收尾,直接终止进程
延迟处理也得有底线。内存继续恶化时,zend_mm_check_limit() 会走 zend_mm_hard_limit_error(),往 stderr 报一声,然后 _exit(137) 直接把进程带走,所有依赖内部状态的请求清理一概跳过。
硬限按分段公式算:软限不超过 1 GiB 时取两倍,超过就在软限上再加 1 GiB,两者也都能显式配百分比——别把“两倍”当成固定规律。
有两个地方容易读错。
一是修复后软 OOM 照样会打印 Allowed memory size ... exhausted,这句报错跟补丁有没有打无关,属于正常现象。
二是 _exit(137) 是 PHP 自己带着状态码退出,和被内核 SIGKILL 干掉完全是两回事。
跨请求状态:把“遗留”变成“不可能”
第二类修复针对 109619:请求结束后,进程级结构里指向请求内存的字段必须清空。
读这段代码,要先分清两样东西:保存地址的那个字段,和地址指向的那份数据。
它们的寿命完全不同。字段所在的结构跟着 worker 长期存在,属于“进程级”;它指向的数据却可能只属于当前这一个请求,请求一结束就该被释放。
麻烦的是,进程级的字段不会自动忘记自己指过什么。好比通讯录里还留着旧地址,原住户早搬走了,下一个人照着地址找过去,只会敲错门——更糟的是,门后可能已经住进了别人。
另外这里的 globals 是内核里的全局结构,跟业务脚本里随手写的全局变量不是一回事。
补丁的做法是在 php_request_shutdown() 里,把 superglobals 析构完立刻置成 UNDEF:
for (i = 0; i < NUM_TRACK_VARS; i++) {
    zval_ptr_dtor(&PG(http_globals)[i]);
    /* May be accessed before php_request_startup() */
    ZVAL_UNDEF(&PG(http_globals)[i]);
}更关键的一手在启动侧:php_request_startup() 里新增 php_basic_early_rinit(),插在 sapi_activate() 之前、请求体解析之前,提前清掉反序列化器等模块的全局状态:
BG(serialize_lock) = 0;
memset(&BG(serialize), 0, sizeof(BG(serialize)));
memset(&BG(unserialize), 0, sizeof(BG(unserialize)));
php_url_scanner_early_rinit();
session 侧还加了个 PS(in_rfc1867_update) 标记:上传进度期间的解码被强制走 incomplete_classes_only 模式,所有对象一律保持 __PHP_Incomplete_Class。这样一来,那些早于业务代码执行的路径上,就不会再触发 autoload 或者 __wakeup() 之类的用户代码了。
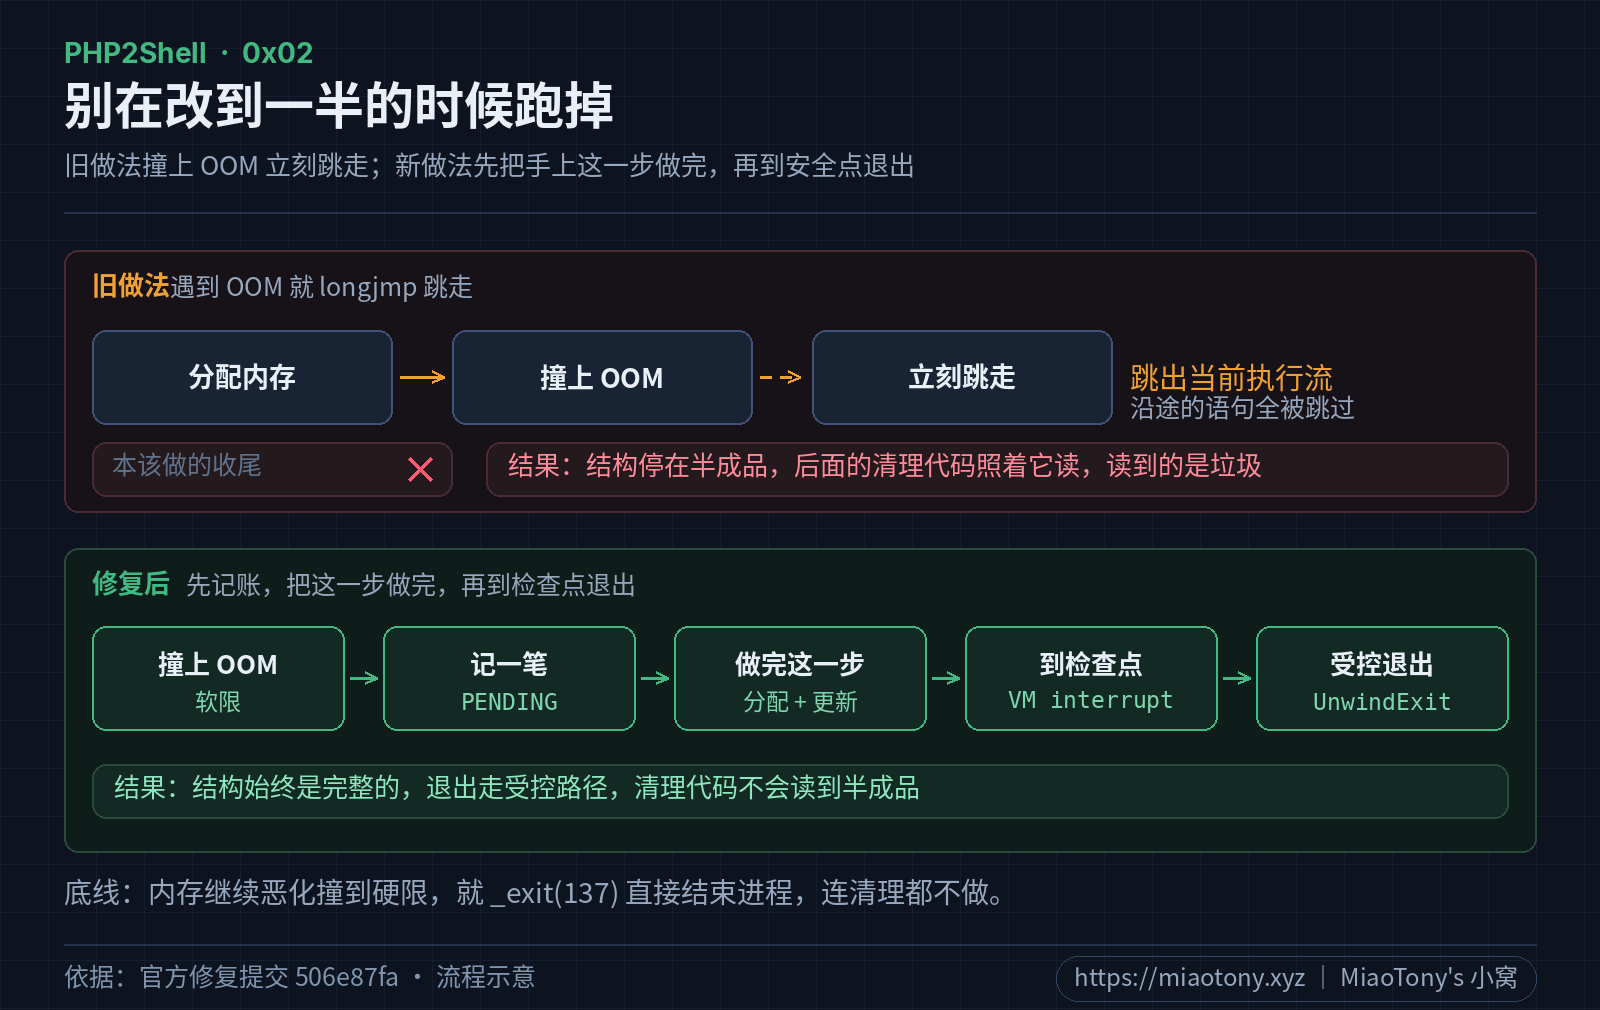
补丁机制概括:退出时机移到安全点,严重故障直接终止进程,跨请求引用在两端都被清理。
补丁修了三件事:软 OOM 别中途跳走、硬 OOM 直接结束进程、跨请求的悬空引用在两端都清掉。把这三件事反过来看,就是三条攻击路径的入口。
接下来的顺序是:先造一个可控的崩溃,再看三条路径各自怎么利用,最后打进 shell。
0x03 公共原语:让崩溃发生在指定的那一行
三条路径都靠同一个前提:不只是把 PHP 的内存撑爆,还得让它在指定的某一次内存分配上爆。
这个区别很关键。内存撑爆本身没什么用,顶多是个 500 错误;真正有价值的是“爆在某个函数执行到一半的时候”。那时代码已经把一半的状态写进了全局结构,剩下的收尾代码却再也不会执行——进程带着一份没写完的账继续活下去,后面谁去读这份账,谁就中招。
所以第一个问题是:能不能挑?答案是能。Calif 公开了两个手法,本质都是同一个放大器——让“请求体有多少字节”和“PHP 吃掉多少内存”脱钩。一旦两者不成比例,把哪一次分配推到临界点,就变成了调参数的事。
第一,绕过 post_max_size 预检。 这个配置本来是防止单个请求太大的闸门。但 PHP 的做法是:拿请求头里声明的 Content-Length 跟 post_max_size 比一下,比完就开始收 body,之后不再核对真正收了多少字节。于是只要让“声明的长度”和“实际喂进来的数据”不一致,闸门就形同虚设。chunked 传输、不带长度的 HTTP/1.1、HTTP/2,都能做到不报长度;配了输入解压过滤器也一样,压缩前一小段数据,解开后能膨胀成很大一坨。
第二,用一个“空壳文件”换来成倍的堆开销。 multipart 里写成 filename="" 的 part 不带任何文件内容,因此也不占 max_file_uploads 的名额——限流对它无效。但 PHP 不会因为它没内容就跳过,照样会为它建满 6 个 $_FILES 条目:name / full_path / type / tmp_name / error / size。更狠的是把字段名写成嵌套结构:
--BOUNDARY
Content-Disposition: form-data; name="files[a][b][c]...[z]"; filename=""

--BOUNDARY--
这一个 part 送进去的内容几乎是空的,可这 6 个条目每一个都要为 files[a][b][c]... 这条路径单独建一套嵌套的 HashTable、Bucket 和 key 字符串。也就是说,一个几百字节的空壳,换来的是成百上千次内存分配。堆上几百个这样的 part,整个 HTTP body 还没碰到默认的 post_max_size(8 MiB),PHP 的堆却已经吃掉了默认 memory_limit(128 MiB)那么多内存。
而因为总量是可控地堆上去的,在哪一步刚好越线,取决于你把 part 排成什么顺序——想让崩溃落在第几个 part、第几次分配上,都提前算得出来。
到这一步,Allowed memory size exhausted 这句原本只在故障时偶然出现的报错,就成了攻击者能掐着秒表按下的开关。
有了开关,下一个问题是:按下去之后,炸在哪里最致命?Calif 找到了三个位置,分属不同模块、不同 SAPI。先看最直接的一个。
0x04 路径①:HashTable 桶的半初始化窗口(CVE-2026-109618)
Calif 在 _zend_hash_str_add_or_update_i 里找到第一个中断点。这个函数负责往哈希表里插入新元素,它插元素的顺序有问题:
idx = ht->nNumUsed++;
ht->nNumOfElements++;

p = ht->arData + idx;
p->key = zend_string_init(str, len, persistent); /* may zend_error_noreturn() */

p->h = ZSTR_H(p->key) = h;
ZVAL_COPY_VALUE(&p->val, pData);问题出在这个顺序上:先把“元素个数”加一,再去分配放 key 的那块内存。
麻烦的是,zend_string_init 一旦分配失败就会触发 OOM bailout,直接跳走。这时候桶里的内容一个字都还没写——key 是空的,值也是空的——可 nNumUsed 已经把它算进了“有效”的范围。
而后面清理的时候,是按这个计数来遍历的:
for (p = ht->arData; p != ht->arData + ht->nNumUsed; p++) {
    i_zval_ptr_dtor(&p->val);      /* 把 stale 字节当 zval 析构 */
    if (p->key) {
        zend_string_release(p->key);
    }
}
于是出现了错位:清理代码坚信“这里有一个元素”,可这个元素从头到尾都没被填完。它就是一块还没来得及写内容的原始内存,却被当成一个活着的 zval,走了一遍完整的析构流程——析构要读这个值的类型和指针,读到的全是别人留下的旧字节。
一个 UAF 原语,就这么到手了。
为什么只有 mod_php 中招? 关键在于中断发生的时机。这条路径的崩溃落在 php_request_startup() 里——也就是 PHP 还在给这个请求做准备工作的时候,POST 变量正在注册(php_register_variable_ex() → zend_symtable_str_update_ind() → 上面那个函数),业务代码一行都还没跑。
崩溃之后,坏掉的那张表会不会被读一遍,取决于 SAPI 怎么处理“启动失败”。有两种截然不同的做法:
mod_php:  php_request_startup() 失败 → 请求清理照常执行
          → zend_array_destroy($_POST/$_FILES) 消费坏表 → worker 存活复用

PHP-FPM:  php_request_startup() 失败 → php_module_shutdown() + return
          → worker 直接退出,坏表随进程消失
换句话说,mod_php 选择“清理完再复用这个进程”,FPM 选择“把这个进程直接扔掉”。
前者意味着那张坏表一定会被 zend_array_destroy($_POST/$_FILES) 遍历一遍,半初始化的桶字节于是被当真的析构;后者意味着坏表随着进程一起消失,什么都不会发生。
具体到代码,mod_php 的 sapi_apache2.c 里,请求构造失败只是 zend_bailout() 跳到外层 handler 处理,php_apache_request_dtor() 依然会去调 php_request_shutdown(NULL),一趟清理照做不误。
这也正是官方敢在 mod_php 上直接验证 RCE、对 109618 的 FPM 却只给“源码分析受影响”的原因——不是没找到,是路径根本走不通。
第一条路径的问题是它绑死在 mod_php 上。而现实里越来越多的服务跑在 FPM 上,如果只到这里,漏洞的影响面就要打个折。Calif 没有停手,他找到了第二个中断点——位置更巧,而且不需要依赖 SAPI 的清理逻辑。
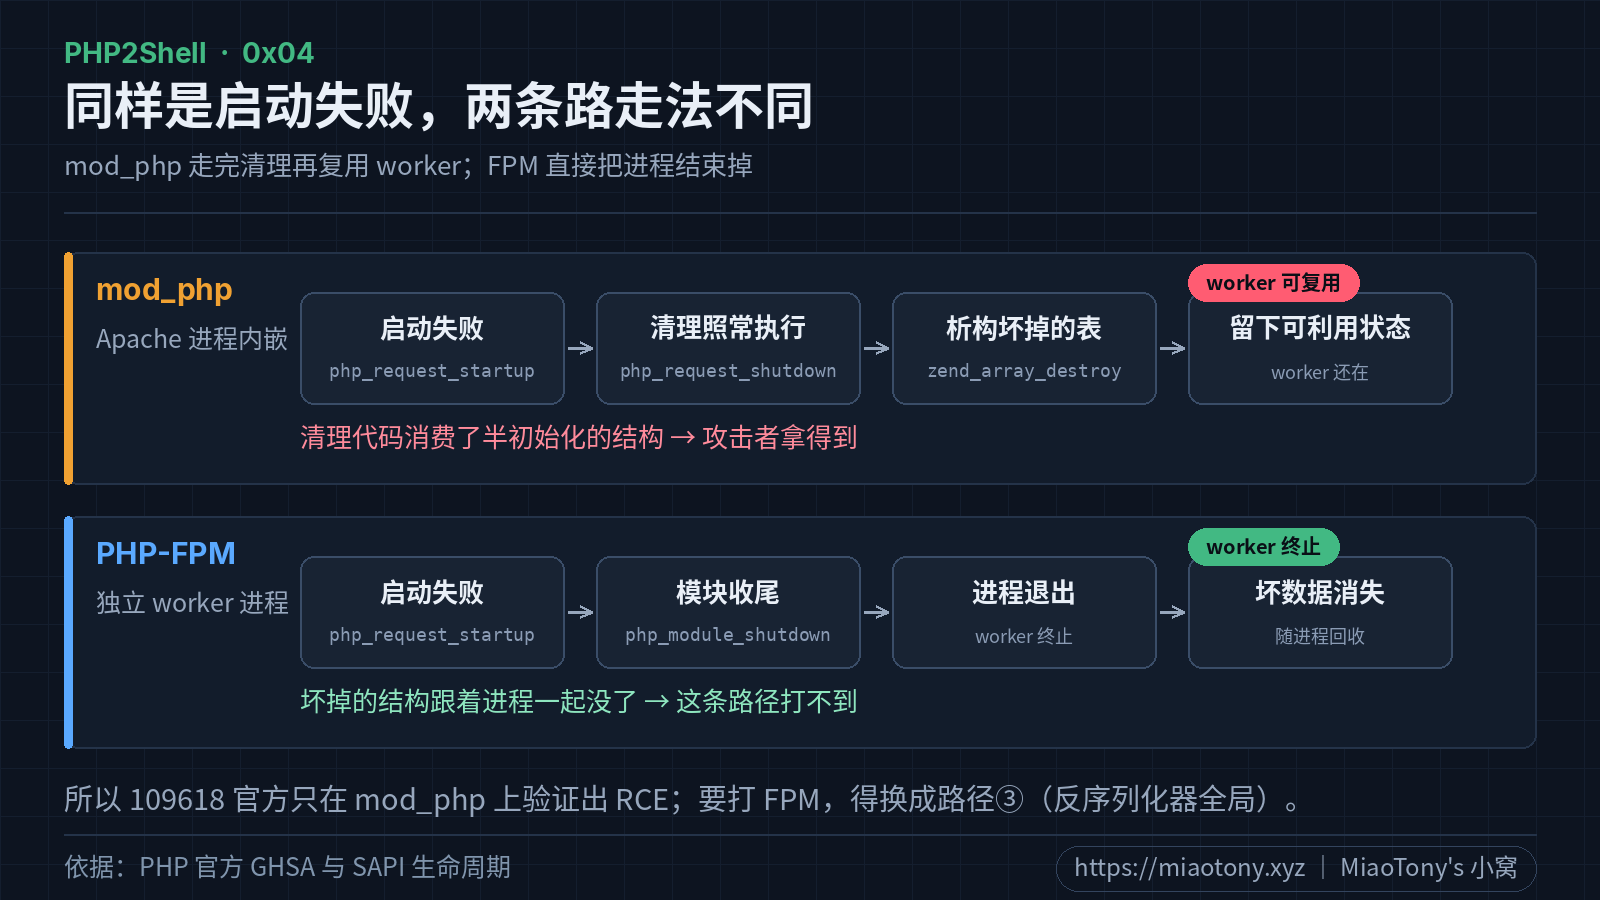
SAPI 对失败请求的处理分流:mod_php 清理后复用 worker,FPM 启动失败退进程、运行期异常则复用——后者正是路径③的落脚点。
第一条路径的结论很清楚:它是 mod_php 专属的。可现实里越来越多的服务跑在 PHP-FPM 上,只到这里,影响面就要打不小的折扣。Calif 没停手,他接着去找第二个中断点——一个不依赖 SAPI 清理逻辑的位置。
0x05 路径②:session 全局的悬空指针(CVE-2026-109619,PHP ≥ 5.4)
第二类中断点更漂亮。session.upload_progress 是个默认开启、但几乎没人用的功能——它存在的意义是让页面能显示上传进度条。问题在于,为了让进度条尽早转起来,PHP 在模块初始化还没完成的时候,就去碰 session 了。
先后顺序错了,状态就有了“已经发布、但还没登记”的窗口。
main/main.c 里,一个请求的启动是这样排的:
php_hash_environment();   /* 解析 $_POST/$_FILES —— multipart 在这里 */
zend_activate_modules();  /* 各扩展的 RINIT */
PG(modules_activated) = 1;
注意这个顺序:先解析请求体(multipart 就在这一步),后激活各个模块。而 multipart 解析到第一个文件 part、触发 FILE_START 事件时,upload progress 会立刻调 php_rinit_session(0),把 PS(id)、PS(http_session_vars) 这些指向请求内存的指针,写进 session 模块的全局变量。
可这一刻 PG(modules_activated) 还是 0。 状态已经发布出去了,那个决定“要不要做收尾”的开关却还没立起来。
如果接下来恰好发生 OOM fatal,请求关闭时就会按 modules_activated 分流——它还是 0,所以走的是下面这条路:
if (PG(modules_activated)) {
    zend_deactivate_modules();      /* session RSHUTDOWN 被跳过 */
}
shutdown_memory_manager(...);       /* 请求堆照常释放 */
后果是:session 的 RSHUTDOWN 根本没跑,没人体面地跟这个请求告别。但下面那行 shutdown_memory_manager() 照常执行——请求占的内存被整体释放了,进程却还活着。
于是 PS(id) 和 PS(http_session_vars) 成了两根悬空指针,指着已经还给分配器的内存。偏偏 mod_php 的 worker 还活着,转身就去服务下一个请求。
消费端同样藏在 upload progress 里,而且设计得相当巧妙。请求 B 只要带上 PHPSESSID 和 PHP_SESSION_UPLOAD_PROGRESS 字段、但不带任何文件 part,就只会走到 MULTIPART_EVENT_END,不会触发 FILE_START。
这一步很关键:FILE_START 里本来有一次“提前把 session 状态重置掉”的操作,现在被绕过去了。于是 END 回调做 cleanup 时,session 以为自己的状态还是好的,重新进到 php_session_initialize():
请求 A: 文件 part → 提前初始化 session → 状态发布 → OOM fatal
        → 跳过 session RSHUTDOWN → 请求堆释放 → worker 存活

请求 B: 无文件 part → FILE_START 重置被绕过 → END cleanup
        → php_session_track_init() → zval_ptr_dtor(悬空的 PS(http_session_vars))
最后这行 zval_ptr_dtor 是整条路径的引爆点:它要析构的对象,指向的是已经被释放的内存。接下来会发生什么,全看请求 B 自己的字段分配有没有先把那块内存重新占住——占住了,析构就是在处理攻击者摆好的数据。
这正是后面 9bie 武器化的主战场。
而这条路径最要命的地方在于,它从 PHP 5.4 起就存在,全程默认配置,应用侧一行代码都不用配合。
不过这条路径有个隐性的前提:worker 必须活着,而且是「不重启就复用」的那种活法。这正是 mod_php 的模型,也解释了上一节那张分流图为什么把 109618 的 FPM 侧标成「源码分析受影响」——不是漏洞不存在,是这条路在 FPM 上走不通。
0x06 路径③:反序列化器全局悬空(打 FPM 的钥匙)
那 FPM 就真的打不了吗?Calif 的答案是:换个切入点。
前两条路径各有各的锁:路径①卡在「启动阶段崩溃,FPM 直接退 worker」;路径②虽然崩溃发生在请求收拾阶段,但它依赖的悬空 session 全局,同样得靠 mod_php 那种复用模型才能延续到下一个请求。
那如果等启动成功之后,再找一个跨请求的共享状态呢?这时候 worker 已经活过了最危险的阶段,异常只影响当前这一次请求,进程照常留着。坏状态就有机会被带进下一个请求。
Calif 找到的入口,是 PHP 通用反序列化器维护的一份共享状态:
if (BG(serialize_lock) || !BG(unserialize).level) {
    d = emalloc(sizeof(struct php_unserialize_data));
    /* 初始化引用表和析构表 */
    if (!BG(serialize_lock)) {
        BG(unserialize).data = d;
        BG(unserialize).level = 1;
    }
} else {
    d = BG(unserialize).data;      /* 复用全局状态 */
    ++BG(unserialize).level;
}这段代码的逻辑是:解码开始前,如果全局状态是“空闲”(level 为 0),就新建一份引用表和析构表,把它挂到 BG(unserialize) 上,并标记 level=1;如果已经在解码了,就直接复用那份全局状态,把 level 加一。
正常流程里,解码结束时会把 level 减回去、释放这份表。但如果应用正在执行 unserialize() 或 session_decode()(WordPress 的 maybe_unserialize() 这类封装也算)时发生 OOM fatal,收尾函数 php_var_unserialize_destroy() 就被跳过了。
结果是:BG(unserialize).data 指向的表已经跟着请求内存一起释放,指针却还留着;level 也停在非零,看起来像“还有人在用”。
关键差别在这里——这次 fatal 发生在启动成功之后,所以 FPM 的 worker 只是这一次请求异常,进程照常活下来。悬空的指针,就这么留在了下一个请求里。
下一个请求还是从同一个入口进——upload progress 在 Basic 模块 RINIT 之前就开始解码。因为 level != 0,解码器认定“已经有人在解码了”,于是照规矩复用那份全局状态,也就是那个悬空指针指向的地方。
而请求 B 那些普通字段的解析分配,早就把那块内存重新占住了。 解码器满心以为在操作自己的引用表和析构表,读到的却全是攻击者预先摆进去的数据。
Calif 从这里提炼出的写原语尤其致命,要害在于析构块里的 used_slots 是个有符号数:
slot = destructor_block + 16 + 16 × used_slots这个下标本来只该是正数,指向块内部的槽位。可既然有符号,攻击者塞一个负数进去,它就会算到块的前面去——落点可以是内存里任意位置。
再在序列化数据里放一组重复的 key,就能触发 var_push_dtor_value(),把一个完整的 zval(指针加类型)写进刚刚选定的那个位置。
往任意地址写任意值——配合前面泄漏出来的堆布局,这就是一个完整的类型混淆原语,稳定性远高于纯粹的堆喷。
mod_php 和 FPM 通吃。官方在 FPM 上验证出的那条 session 生命周期 RCE,走的正是这条路。
三条路径到这里就齐了。它们共用同一个「可控 OOM」的生产者,消费端分别落在哈希表计数、session 全局和反序列化器全局上——这已经足以构成漏洞的全部理论形态。
但理论形态和「真的敲一条命令拿到 shell」之间,还有相当长的一段工程路。
0x07 武器化:9bie 的纯 HTTP 链逐段拆解
这段工程路要翻三座山:ASLR 让地址每次都变,堆布局决定了谁能占住哪块内存,而触发过程必须稳定到能重试。这三件事凑不齐,原语就只是原语。
ASLR(Address Space Layout Randomization,地址空间布局随机化) 是操作系统的一项防护:把程序、共享库、堆、栈这些区域的装载或分配位置随机化,让人没法预先猜到内存地址。
9bie/php2shell-bypass-aslr-exp 把最后这一公里也公开了。这个仓库在披露后两天内更新了好几轮,最后落地的版本比初版激进得多——目标环境是原封不动的官方镜像:php:8.4.26-apache、官方 php.ini-production(display_errors=Off、memory_limit=128M)、官方 prefork 配置(MaxRequestWorkers=150),不挂 gdb、不读目标 /proc、不改任何配置,目标页面就是开头那个 <?php echo "OK\n"; ?>。
仓库自己报的成绩:官方 worker 配置下 10/10,单 worker 基线 20/20,单次 3–4 秒。
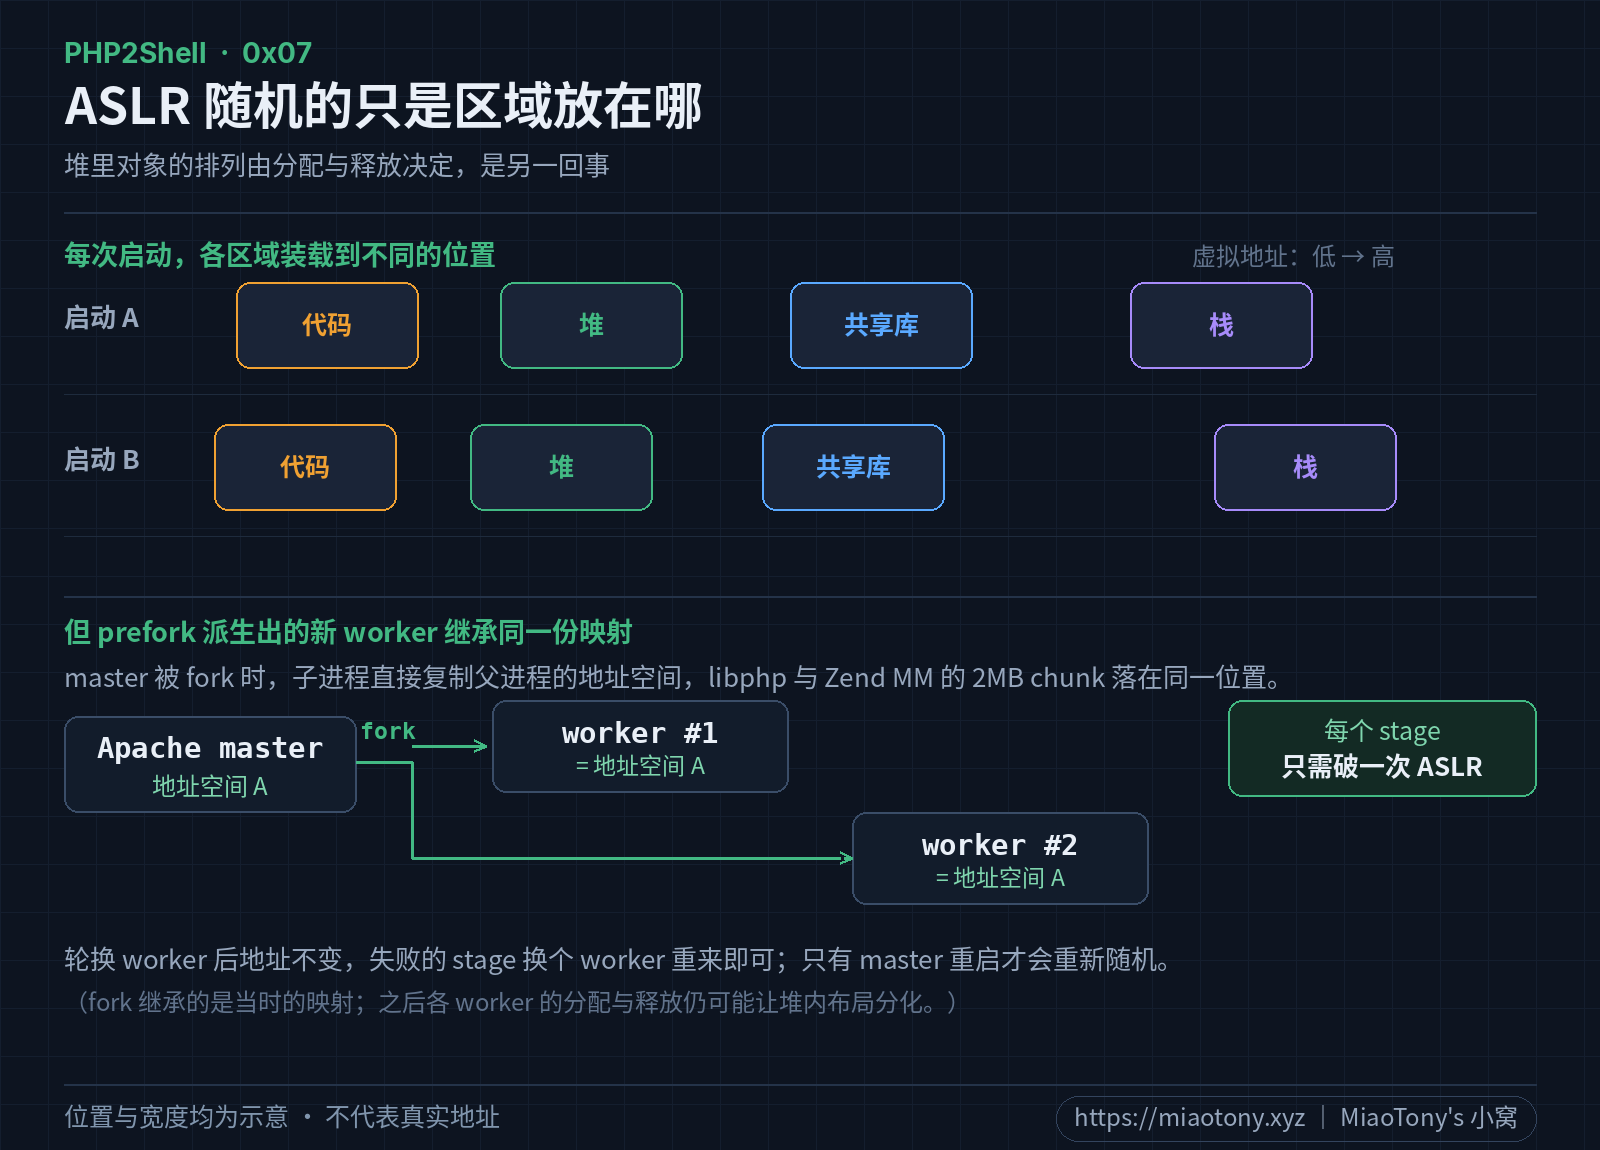
区域基址与堆内对象排列属于不同层次;图中位置与宽度均为示意。
先把这条链看成两轮接力,而不是一串函数名:第一轮读出地址,第二轮利用这些地址触发命令执行。 仓库用 A1、B1、A2、B2 给四个关键请求编号,含义如下:
- 制造异常(A1):让 session 留下指向已释放内存的引用。
- 读取地址(B1):用新请求的数据占住那片内存,让响应带出堆和 libphp 的地址。
- 再次制造异常(A2):让 session 的校验状态留下失效引用,为下一次替换对象做准备。
- 布置并触发(B2):根据已知地址布置假对象,借请求收尾时的析构调用触发命令执行。
A 表示制造异常,B 表示接着使用坏状态;数字表示第几轮。这四个是关键利用请求,不包括占位连接和热身请求。请求失败不等于进程退出:这条链恰恰需要 worker 活下来,继续处理下一步。
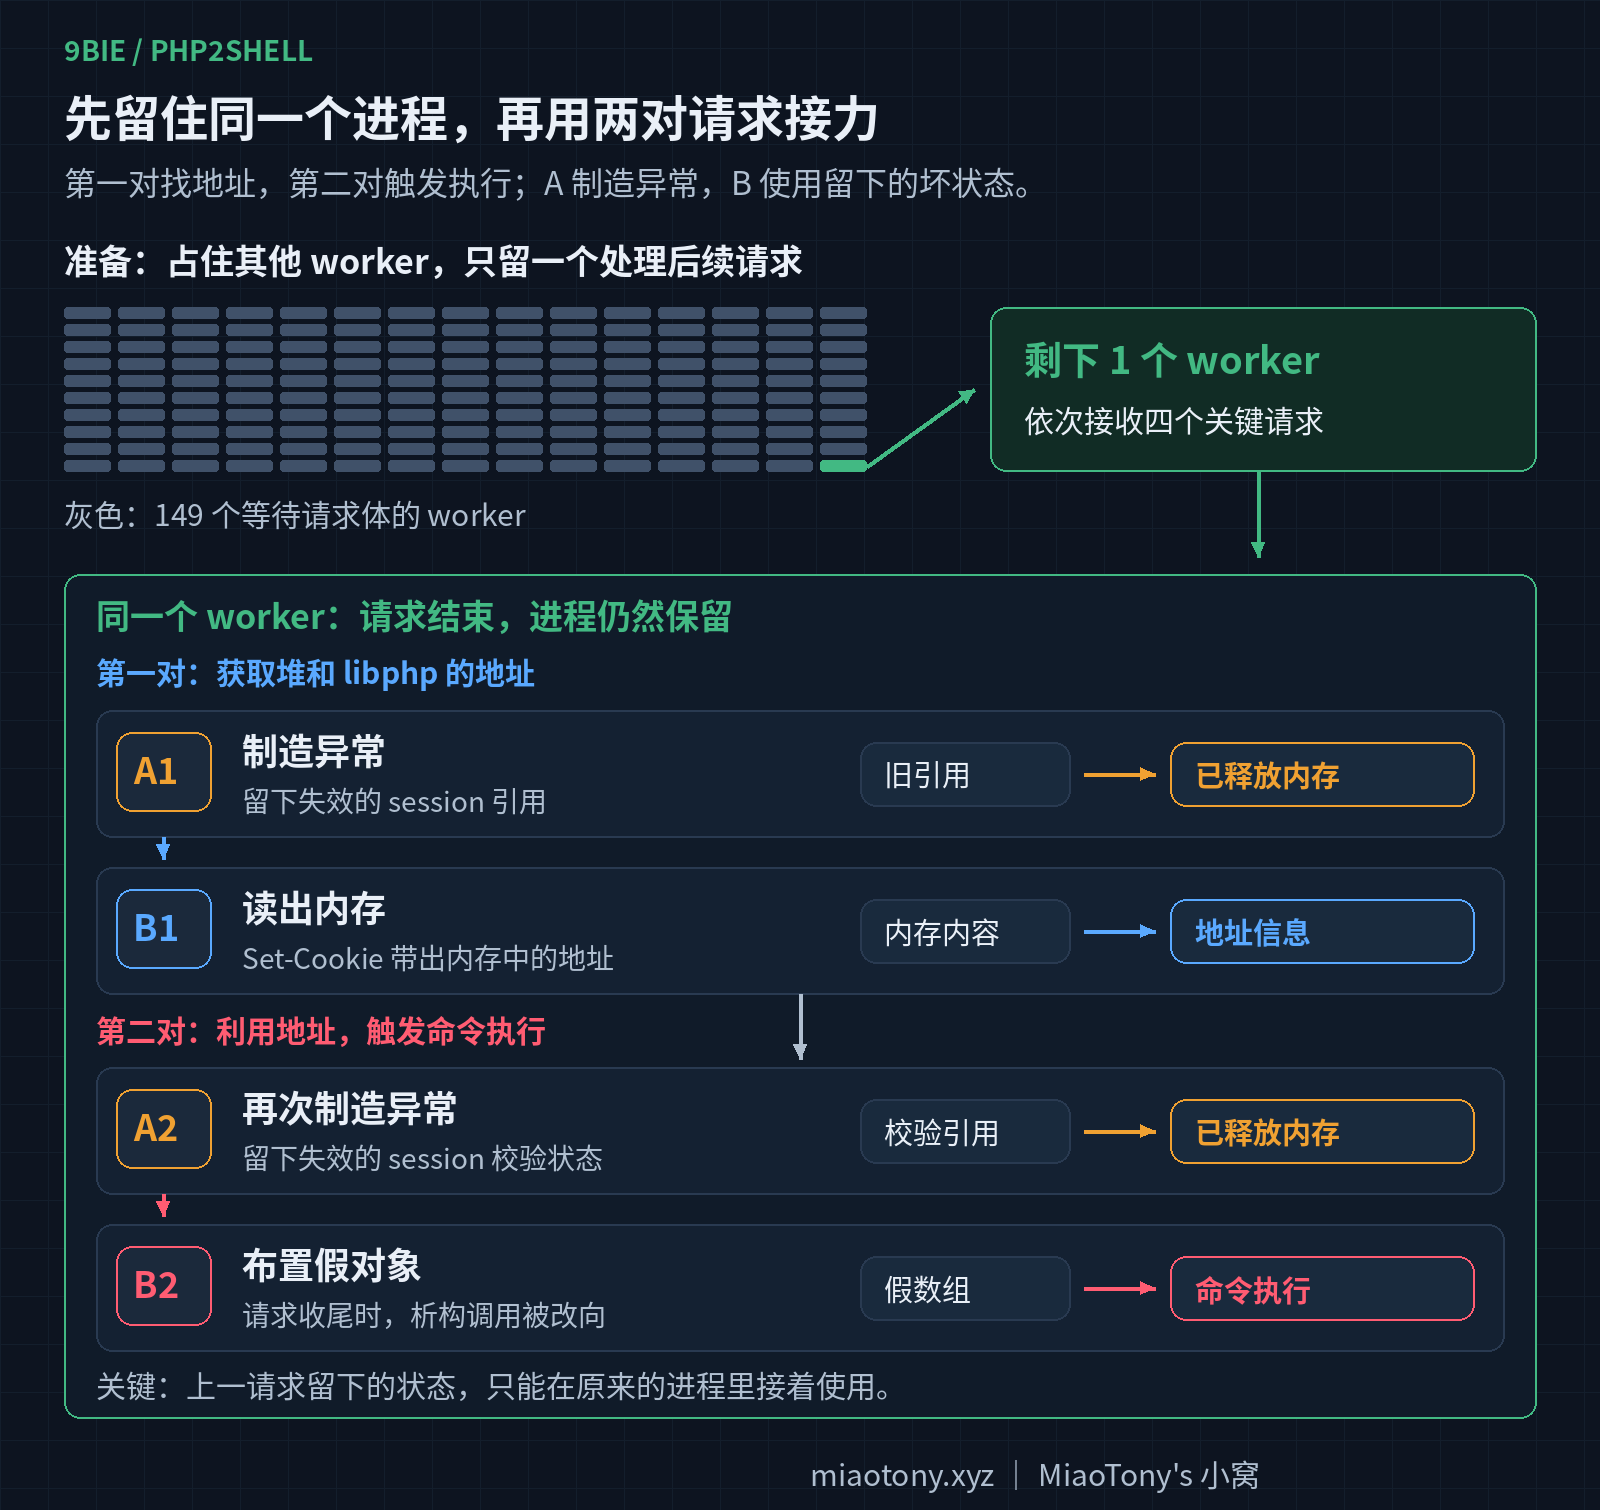
Stage 0:先让后续请求落到同一个 worker
为什么先处理 worker?因为失效引用留在某个进程自己的内存里。如果「制造异常」的请求由一个 worker 处理,「读取地址」的请求却到了另一个 worker,后者就接不到前者留下的状态。
仓库使用的官方 prefork 配置是 StartServers=5、MaxRequestWorkers=150:启动时先创建 5 个进程,按负载增加,最多同时处理 150 个请求,并不是一启动就有 150 个 worker。
9bie 的办法是用未完成的请求占住其他 worker,只留一个继续工作。这些连接只提交一部分请求体,接收它们的进程便暂时等待剩余数据。在仓库的 150-worker 测试配置下,149 个这样的占位连接让其他进程都处于等待状态。
剩下的 worker 依次处理「制造异常 → 读取地址 → 再次制造异常 → 布置并触发」。每次请求结束,它又成为唯一空闲的进程,下一步便能接着使用同一份进程内状态。这种做法叫 worker pinning(固定处理请求的进程),不是修改服务器配置,把 worker 数量真的调成 1。
这个前提依赖具体部署。代理是否缓冲请求体、读请求体的超时限制,以及并发的正常业务流量,都会影响占位效果;仓库的成功记录不代表任意站点都能照搬。
Stage 1:chunked 绕过 post_max_size,先把堆整好形
堆布局需要往请求里灌远超 8MB 的数据,但默认 post_max_size 就卡在 8M。0x03 提到的绕过办法在这里落地了:不带 Content-Length,用 Transfer-Encoding: chunked 发。
这样 SG(request_info).content_length 就是 0,rfc1867_post_handler 入口处那个 post_max_size 比较直接被跳过;而 Apache 的 LimitRequestBody 默认是 0(不限制)。multipart 解析器只管读 dechunk 之后的数据流,不再有任何总量核对。实测 10MB、63MB 的 body 都能正常解析。
Stage 2:Set-Cookie 越界读,一次拿到两个地址
这是整条链最精巧的一段。
先看制造异常的请求(A1)。它是一个精心配比的 multipart 请求:860 个深度 64 层的嵌套空文件字段、14 个 filler、78 个 8KB 大值、20 个 4KB burner,最后是 4000 字节的 PHP_SESSION_UPLOAD_PROGRESS。这个配比让 OOM 精确发生在 php_url_encode() 里,也就是 session 写 cookie 的那一刻。
崩在这一刻的后果是:PS(id) 和 PS(mod_data) 都成了悬空指针,而 PS(send_cookie) 已经被置成 1。请求返回 500,但进程活了下来。
接着是读取地址的请求(B1)。它用一个超长的 forge 值,把 A1 留下的悬空 PS(id) 指向一块伪造的 zend_string 头——len 字段写成 0xC8000(800KB),data 首字节写成 /。/ 很关键:它会让后续的 php_session_valid_key() 校验失败,从而走 abort 分支,但在这之前 Set-Cookie 已经把 800KB 内存 urlencode 出来了。
一个 Set-Cookie 头,800KB 的数据外带。窗口里同时能捞到两样东西:
- 堆基址:所有 0x7f 开头的指针按 2MiB 对齐聚类,落在最前面的那个簇就是 id 所在的 Zend MM chunk;
- libphp 基址:窗口里还出现了 1095 次同一个指针——那是真实 HashTable 的
pDestructor = zval_ptr_dtor。原因挺巧妙:G:400这个 forge 值在 id chunk 尾部留下 111 页空洞,随后 900 个嵌套数组字段的真实 HashTable 被 Best-Fit 塞进了这些洞里。减去固定偏移0x65EB60,libphp 到手。
这一步还带了合理性检查:libphp - main 必须落在 0x1A00000–0x1F00000 区间内。不在就说明窗口里「出现最多的指针」是别的模块的重复值,这次泄漏作废,整条链从 A1 重来。加固前失败过的那一次,就是靠这个检查识别出来的(当时推出来的差值差了 0xCB80000)。
Stage 3:伪造 HashTable,让 PHP 自己调 system()
地址齐了,最后一步是把控制流接到 zif_system。
再次制造异常的请求(A2)沿用空文件元数据放大分配的办法(cheap-OOM):880 个 part、深度 64、115 个 filler,让 PS(hash_serialize_verifier) 悬空并指到 main + 0x7D720。
布置并触发的请求(B2)接着使用这份失效状态:用 384 字节的引用值把那个悬空指针覆盖成指向 S = main + 0xF8398 的 zval;S 处摆好一个伪造的 zend_array,把 pDestructor 写成 zif_system(libphp + 0x465370),arData 指向命令字符串 "id>/out/p1"。
请求 shutdown 时,zend_hash_destroy 遍历到伪造的表,调用 pDestructor——system() 就这么执行了。命令输出落在挂载目录里,取回来就是 uid=33(www-data)。
这条链没有使用 ROP;它通过伪造析构函数指针改变控制流,让 PHP 在收尾时调用攻击者选定的函数。仓库用实验环境的挂载目录保存执行结果,这属于验证方式,不是任意远端站点天然具备的条件。
新旧两条链的差别
9bie 仓库早期那一版依赖两个并不常见的配置:display_errors=On(借警告输出把 headers_sent 置 1,才有机会在响应里加头)和单 worker 的 prefork 配置。这两条让它在真实环境里的适用性打了不小的折扣——生产环境的 php.ini 通常是 display_errors=Off,而 prefork 也很少只配一个 worker。
现在的版本把这两个前提都去掉了:
| 早期版本 | 当前版本 | |
|---|---|---|
display_errors |
必须 On |
任意,Off 也可 |
memory_limit |
需改小 | 官方 128M 即可 |
| worker 数 | 单 worker | 官方 150 也打通 |
| 目标 ini | 自定义 | 官方 php.ini-production |
| 泄漏方式 | 依赖警告触发 headers_sent |
Set-Cookie 越界读 800KB |
| 成功率(作者报告) | 3/3 | 单 worker 20/20,官方 worker 10/10 |
这也是这条链最值得警惕的地方:所有前提条件都已经收窄到「官方默认配置」。不需要目标站点有任何错误配置,只要能往一个跑 mod_php 的 Apache 发 HTTP 请求。
顺手盘点:研究笔记里的可复用部件
仓库里几个部件在别的场景同样好使:
- chunked 绕过 post_max_size:这不是 php2shell 专属的,任何需要「body 大于 8M 但又不触发限制」的堆整形场景都能用;
- Set-Cookie 作为外带信道:只要能把某个长度字段改大,cookie 的 urlencode 就是一条现成的、不带响应体的越界读通道;
- worker pinning:用不完整请求占满 prefork 子进程,这个技巧与 PHP 无关,任何需要「请求必须落在同一个进程」的利用都能复用;
- A/B 请求对:A 制造悬空+内存布局,B 重占+消费,中间靠 worker pinning 保证地址连续性。
值得一提的是,这条链的每一环都只用到了 HTTP 请求和响应。没有内存泄露工具、没有调试接口、不需要服务器上有任何可疑进程——在日志里,它看起来就是一串格式怪异的表单提交,外加 149 个半截断的 POST。这也解释了为什么防守方必须在补丁层面解决,而不是指望从流量里拦住。
0x08 防御:在链条上动刀
既然攻击是「可控崩溃 → 命中三个消费点 → 绕过 ASLR → 接上 system」这么一条链,那么防御也就不必想着「一招制敌」,而是看在哪一节最划算。
按性价比排,优先级是这样的:
安装官方修复:升级到官方已发布的修复版本,或安装发行版明确回补这两个 CVE 的包,并重启全部 PHP worker。本次首批修复版本为 8.5.12 / 8.4.27 / 8.3.36 / 8.2.35;实际更新时以官方当前安全公告和发行版维护记录为准。补丁同时调整 OOM 处理、请求结束清理和 early RINIT,分别处理异常退出时机、失效引用和过早访问的问题。
临时缓解按环节选:
session.upload_progress.enabled=0斩断路径②③的消费者——B 请求的提前 session 处理直接消失,官方和 Calif 都点名的首选。这功能默认开启而几乎没人用,关了损失很小;memory_limit=-1移除 OOM 生产者,但引入资源耗尽风险,只配合容器 / cgroup 边界短期用。RLIMIT_AS/RLIMIT_DATA反而会制造底层分配失败,官方明确警告别用;- 关
display_errors曾经有用——早期利用链靠警告输出把headers_sent置 1,不显示警告就凑不出外带信道。但 9bie 现在的版本改走Set-Cookie越界读,display_errors=Off已经是它的目标环境之一,这一条已经失效。
值得单独说的是:这三条里只有第一条(关 upload progress)还站得住。memory_limit=-1 要冒资源耗尽的风险,而关 display_errors 已经被绕过。也就是说,临时缓解的窗口正在关闭,能打补丁就尽快打。
检测面(来自利用代码的具体特征):
- 异常巨大的 Set-Cookie:当前版本一次外带 800KB,编码后响应头在 1.5–2.3MB 量级。这是最强、也最容易写的单点信号——正常应用的 cookie 不会超过几 KB。
- 149 个半截断的 POST:worker pinning 会先开
MaxRequestWorkers-1个连接,每个只发 POST 头和 1 字节 body 就挂住。短时间内大量连接卡在读 body 状态,是相当反常的形态。 - 带 PHP_SESSION_UPLOAD_PROGRESS 却不带文件 part 的 multipart 请求,以及单请求上千字段、单字段十几 MB、深度几十层的嵌套字段名。
- Transfer-Encoding: chunked 的超大 multipart 请求体:不带
Content-Length却发送远超post_max_size的数据,Apache 访问日志里%b会明显偏离正常分布。 - worker 反复 SIGABRT 的 502 尖峰;日志里
Session ID is too long or contains illegal characters与Failed to read session data成对出现。
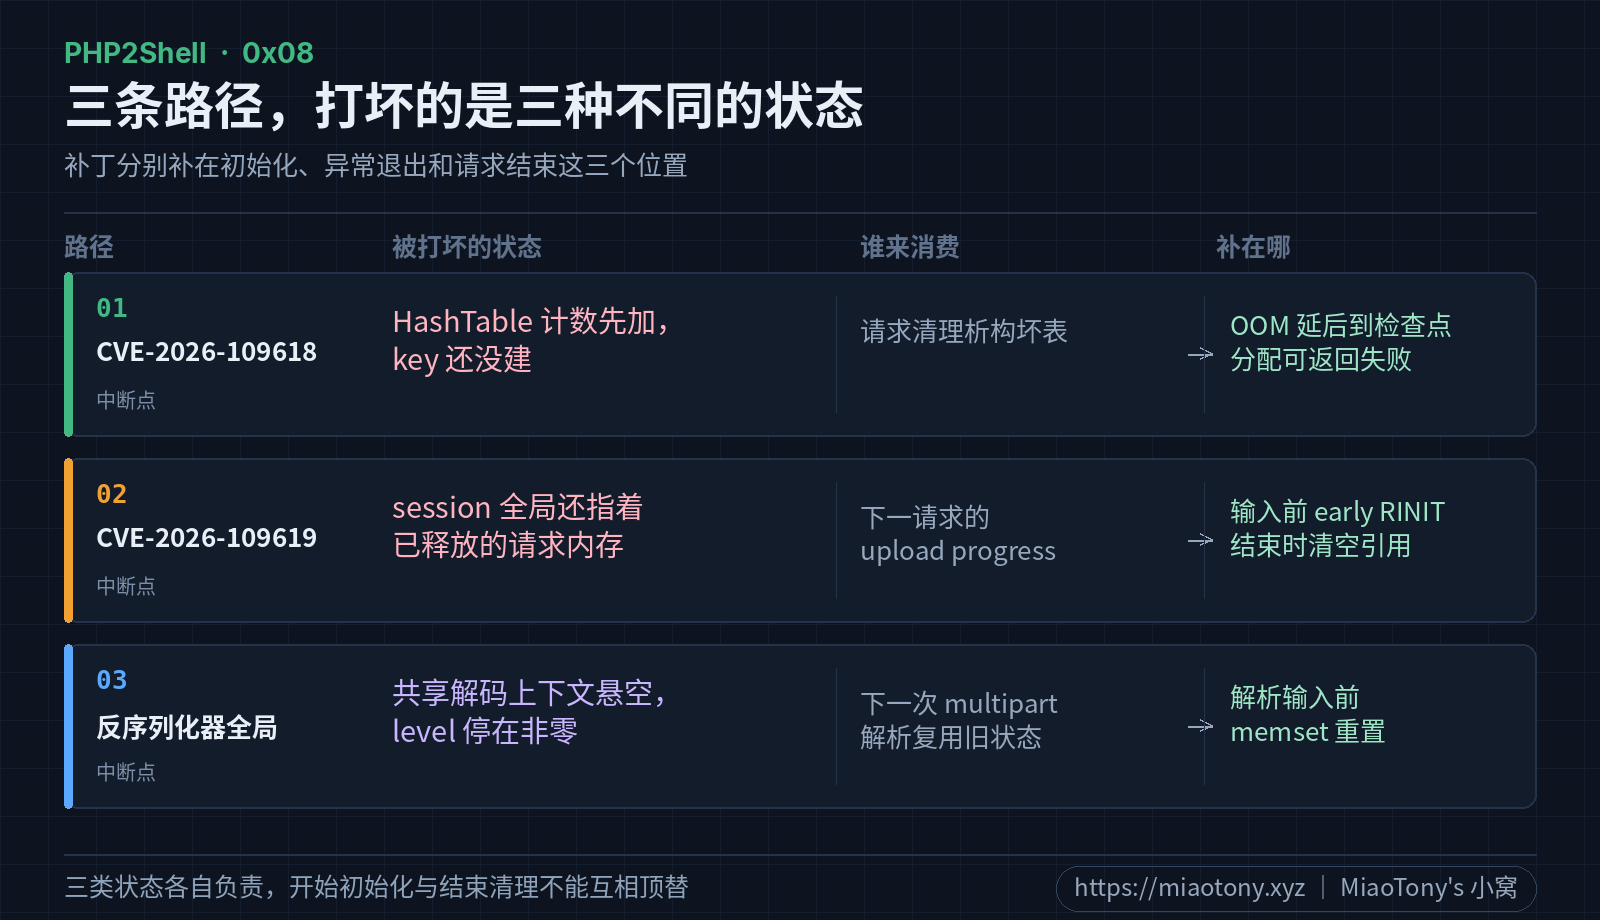
三类问题涉及不同状态,补丁分别处理元素可见性、请求内存引用和共享解码上下文。
链条上的每一个「消费点」,在补丁里都能找到对应的一处改动:桶的可见性、请求内存的引用、共享的解码上下文。这也是为什么升级之后必须重启 worker——补丁改的是进程内状态的生命周期,热加载一个库文件解决不了问题。
0x09 小结
回到 10 月 21 日那个晚上。那么多公司同时选择停服,首相亲自发推喊话——搁在平时,这些反应看起来未免过激。看完这条链就会发现,它们其实相当克制:漏洞不需要任何业务代码配合,一个只写了 echo 的页面就是攻击目标;而修复必须替换运行中的进程,停服几乎是唯一能保证窗口期安全的选择。
PHP2Shell 真正的价值,在于它把一条埋了二十年的线走通了:内存耗尽从“故障”变成了“可控中断”,而中断又恰好落在内部状态发布与提交之间的那道缝里。
三条路径共用同一个生产者原语,消费端则分别击中 HashTable 计数、session 全局和反序列化器全局。SAPI 对启动失败的处理差异,决定了 mod_php 先倒下;而应用层的解码操作,让 FPM 同样守不住。
补丁的修法本身就是个提醒:把软 OOM 的处理挪到受控检查点,用硬限约束还能分配多少余量,再把请求两端的状态清理补齐——三处改动分别对应三条路径。
而 9bie 那条链的演进,给出的是另一个维度的警示:漏洞从「理论可打」到「官方默认配置下稳定可打」,只用了两天。披露当天的版本还依赖 display_errors=On 和单 worker;一天后,官方 php.ini-production、官方 150 worker 全部打通,成功率 10/10。中间没有出现新的 PHP 缺陷,只是利用工程在往前拱。
这意味着「等别人先被打、我再看情况」这种心态,在这类漏洞上几乎没有缓冲期。
对写 C 的工程师来说,这提醒我们重新审视“先更新记录、再执行可能失败的操作”这种很常见的顺序:一旦操作中断,后面的代码究竟会把这条记录当成什么状态?
IceSolst 在 X 上的这段调侃,倒很贴切:
如果你先发布补丁,它会得到一个 PoC。
如果你不发布补丁,人们会在你身上烧掉数百万个 token,并得到更多 PoC,包含你尚未修补的新漏洞。
这轮修复也值得继续跟踪:同类问题可能仍有遗漏,后续研究还可能找到新的异常路径或变体。 先更新,再关注 PHP 官方安全公告、版本更新记录、watchTowr 的 PHP2Shell 跟踪分析 和发行版后续通告,两件事应当一起做。
对维护者来说,修复、回归测试和后续审计需要持续推进;对使用者来说,及时更新并确认运行中的 worker 已切换,仍然是当下最实际的行动。
0xFE 附件:当晚维护公告核实清单
开头那张汇总图只是节选。当晚的核实清单整理成了一份 PDF:至少 17 项明确关联 PHP 的维护记录(至少 9 款游戏或相关服务、至少 8 组平台厂商服务),外加 4 项同期但官方未点名 PHP 的安全维护单列对照,每项都附有摘要、官方原链接与公告截图。
核对口径:时间统一换算为北京时间,截至 2026 年 10 月 22 日 00:18;日本厂商的公告不代表所有地区服务器都受影响;名单非穷尽,欢迎补充。
📄 PHP 漏洞维护公告汇总(2026-10-21).pdf(4.3 MB)
0xFF 参考资料
- PHP 官方紧急安全公告与缓解措施
- CVE-2026-109618:RCE via OOM corruption(GHSA-w8hw-w9fx-j79w)
- CVE-2026-109619:RCE via stale global state(GHSA-6wmf-4rv5-p3rp)
- PHP 8.4 安全提交:Avoid state corruption via bailout
- PHP 8.5 安全提交:Avoid state corruption via bailout
- Calif:PHP2Shell 一手研究
- 9bie:php2shell-bypass-aslr-exp 公开利用实现(官方 128M /
display_errors=Off纯 HTTP 链,含 机制与标定 与 官方 worker 日志) - Wiz:PHP2Shell 技术分析
- PHP Bug #78876:multipart 长变量 OOM(2020)
- PHP:Session Upload Progress 手册
资料与代码阅读截止于 2026 年 10 月 22 日。