免责声明
本文由 LLM 参与创作。视频使用 Opus5.5 创作完成。
文中引用了官方文档、公开项目及研究材料,性能数据会注明来源。本文未独立实测 Jev API,示例数值仅用于说明。
0x00 引言
最近整理了一些 Jev 的资料,也翻了翻 Awesome Jev 里收录的项目,发现这个模型的用法还挺有意思的。这里把相关原理、接口和应用例子整理一下,顺便放上做好的介绍视频。
先看一个很常见的场景:
我已经问了三次,能找个真人吗?
客服系统收到这句话,需要判断分到哪个队列、有多紧急,以及要不要人工接手。
用大模型处理的话,可以让它分析这段内容,再输出 JSON。不过后面的程序真正用到的,可能就只有一个队列名、一个优先级,以及是否需要人工处理。
为了得到这几个值,先生成一段文字,再解析回来,这一步能不能省掉呢?
Jev 就是专门做这类判断的模型。 给它材料、问题和允许的答案,它返回选项、分数或“是”的概率,程序再根据结果继续处理。至于写回信、生成代码这些工作,还是得交给生成模型。
这类需求平时其实不少。比如给邮件分类、判断检索结果是否有用,或者给 Agent 选一个工具。纯规则有时候写不全,用通用大模型又要考虑延迟和费用,Jev 提供了另一种选择。
下面这个 5 分钟的 4K 介绍视频使用 Opus5.5 创作完成,可以先看一下。想直接看文字的话,往下翻就好。
0x01 Jev 简介
TypeSafe AI 于 2026 年 9 月 15 日发布 Jev,把它称作 System One Model。名字借用了《思考,快与慢》中的快速、直觉式判断;Jev 则来自经济学家 William Stanley Jevons,呼应效率提高后使用量可能反而增长的“杰文斯悖论”。这里借用的是快速判断的概念,具体能力还是要看任务表现。
可以把 Jev 理解成一个用自然语言定义任务的决策服务。它面向有限答案空间,适合邮件分类、检索重排、内容判断、模型路由和动作选择。要写邮件、解释原因、生成 SQL 或长篇规划,仍然需要生成模型或其他程序。
先把几个基本情况说明一下:
- 只接受文本输入。
state可以用字符串、JSON 对象等表达,但不原生接收图片、音频或视频。游戏画面和网页截图通常是展示给人看的,送给 Jev 的是外围程序整理出的文字状态。 - 模型是闭源托管服务。 官方公开了 SDK,未提供可自行部署的 Jev 权重或完整训练实现。SDK 开源,不等于模型开源。
- 问题与候选由应用提供。 候选里没有正确答案,模型也不能凭空增加一个。需要的时候,应显式准备“其他”“证据不足”或“转人工”。
- 流程状态由应用维护。 历史、记忆、权限、浏览器操作和结果验证,都不能因为接了 Jev 就省掉。
文中接口以 jev-1.13.0 为例。版本、价格和容量可能变化,接入时应再核对模型文档,不要把 jev-latest 当成永远不变的型号。
0x02 三种基本接口
沿用前面的工单,一次请求就可以同时询问队列、紧急程度和是否需要人工。
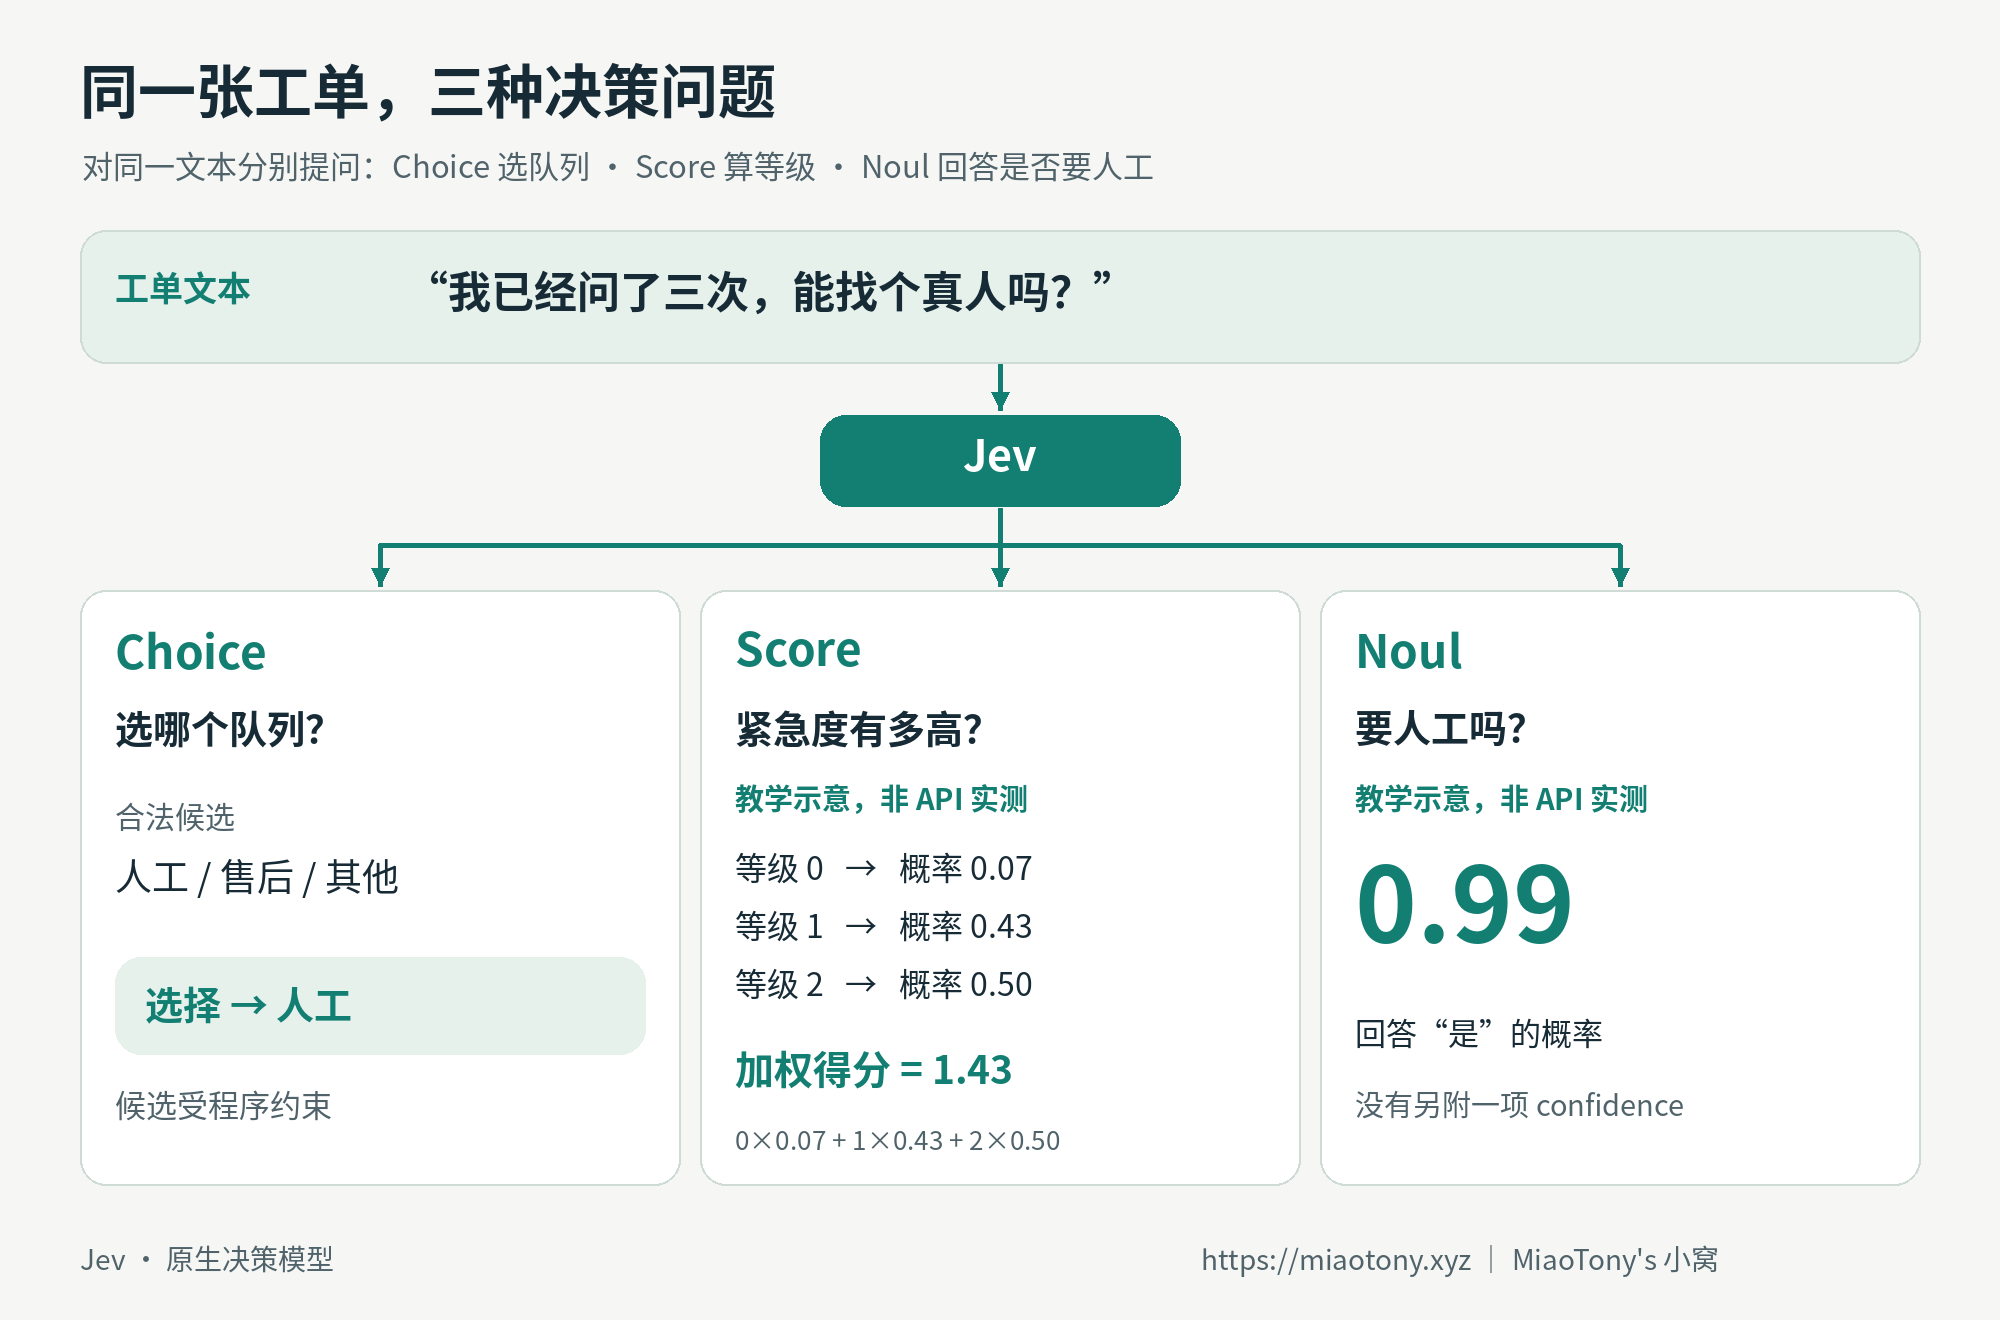
图:三种问题共享同一份输入材料。图中选择和概率用于讲解,未经 Jev API 实测。
Choice:选哪个
Choice是在你给定的候选中做选择。例如,把工单分到“人工客服”“售后处理”或“其他”。返回内容包括选中的 choice、候选项的 probabilities,以及 confidence。
它适合分类和路由,也可以用来选择工具、页面控件或游戏动作。当前文档的候选数量上限是 255,但“能塞进去”不等于“应该塞满”:候选名称含糊、相互重叠时,后面的概率也很难解释。
如果只是想判断“有没有明确要求人工”,没必要设计十个客服去向;如果动作必须互斥,则用一个 Choice 通常比为每个动作分别问“要不要执行”更清楚。
Score:打几分
Score先定义一组有顺序的等级,再为这些等级分配概率。例如:
- 0 级:普通咨询,可以排队处理。
- 1 级:重复追问或问题拖延,需要优先跟进。
- 2 级:明确升级诉求,需要尽快人工处理。
返回的 score 是等级索引的概率加权值,可以落在两档之间。假设三档概率分别为 0.07、0.43、0.50,结果就是:
0 × 0.07 + 1 × 0.43 + 2 × 0.50 = 1.43也就是说,1.43 是这些等级的加权结果。这个值可以用来排序或设定处理门槛,但不能直接换算成正确率。
Score 适合评估紧急度、相关性或风险程度,不适合拿来精确预测金额、计算日期差或数清字符。当前 API 最多接受 10 个等级;等级定义写得越具体,分数才越有业务含义。
Noul:判断是否成立
Noul返回某个命题为真的概率,字段名是 noul,取值范围为 0 到 1。例如:“客户是否明确要求真人客服?”
它的读法很容易弄反:
0.99:模型倾向于“是”。0.02:模型倾向于“否”,并不表示“只有一点把握”。- 接近
0.5:两种结果难以区分。
注意,Noul 返回的是概率值,也没有额外的 confidence 字段。 是否变成 true/false,或者把中间一段划作“需要复核”,由应用自己决定。名字与 Bernoulli(伯努利)有关,这一点可参见 Simon Willison 的介绍。
三种问题可以混在一次调用里并行评估。但某个问题如果依赖前一个答案,比如“先选出工具,再依据它的能力生成参数”,仍然要拆阶段。并行提问不会自动建立问题之间的推理顺序。
0x03 为什么它可以更快
通用生成模型通常沿着 token 序列一步步产生答案。即使最后只需要一个分类,应用也可能承担提示组织、输出生成、解析和校验的开销。
按照 TypeSafe 的官方解释,Jev 放弃自由文本输出,使用面向类型化决策的架构与并行采样方式,直接产生这些问题所需的概率。它的训练方法称为 RLCD,Reinforcement Learning for Calibrated Decisions,目标包括让输出概率适合后续决策。
这里和 temperature、top-p 的作用有区别。它们控制的是生成模型的采样;Jev 直接针对事先定义好的答案空间输出概率。接入时,需要调整的主要是问题、候选,以及接受结果的阈值。
当然,分类器、reranker 和约束解码这些方法早就有了。普通 LLM 也可以借助 JSON Schema、受限解码或短标签输出减少格式错误。Jev 的产品价值要看它能否以合适的效果、延迟和成本,省掉你原本需要自行拼装的那部分实现,不能仅凭“System One”这个名字判断技术先进性。
公开资料也不足以重建 Jev 的全部内部实现。不要把“非逐 token 生成”继续推导成某个确定的基座、参数量或网络结构;创建者访谈解释了设计目标,但不等于公开了可复现训练配方。
一次判断便宜,不代表整条任务一定便宜
官方公开报价为 每百万输入 token 0.042 美元,输出免费。按这个单价,假设每次计费输入恰好是 1,000 token,那么 1,000 次请求的输入费用是 0.042 美元。
这里只按公开单价换算,未实际调用 API 测试费用。真实输入还包括问题和候选;重试、其他模型、解析、检索、浏览器运行及人工复核的成本也需要另算。
官方发布文报告过 70—500 毫秒端到端延迟,测试主要从美国西海岸发起。网络距离、长输入、候选规模、网关和重试都可能改变你的实际等待时间。所谓“快约两百倍”“便宜约四百倍”,来自特定工作流和对照条件,不能改写成所有任务上的保证。
读官方评测时还需要注意:其中部分参考标签来自强模型的共识,测的是与这些标签的一致程度;让对照 LLM 输出完整概率分布,也不等价于让它只回答一个标签。图表可以帮助发现值得试的方向,采购和上线仍要用自己的数据做对照。
第三方研究里,简单判断和难题的差距
除了厂商图表,CMU 团队的预印本 JEV-as-a-Judge:Accept When Confident, Escalate When Unsure(v3)也研究了把 Jev 当作裁判的做法。这是第三方的评估研究,主要看裁判效果,不涉及 Jev 本身的训练实现。
论文主表中,1,500 对 RewardBench 样本上,Jev 1.13 与 GPT-6 Astra 都是 92.5%;到了 350 对 JudgeBench 样本,两者分别为 78.6% 和 93.1%。同一篇论文里的差距,就足以提醒读者:能从文本直接判断的任务,与需要推导的数学、代码和逻辑问题,不能混成一个“模型智力”数字。
论文的计时面板每个托管裁判测了 120 次判断,Jev 的中位延迟为 0.15 秒,按报告用量估算的费用为每千次 0.044 美元。这些是作者在指定任务、提示和网络条件下测得的结果,费用按报告用量估算。
作者进一步尝试了“有把握就接受,拿不准就交给更强模型”的级联。这个思路可以借鉴,但有个接口细节不能漏:论文用于路由的 q 是最大标签概率,与 Jev API 原生的 confidence 字段定义不同。照搬阈值之前,先确认比较的是同一个量。
0x04 Awesome Jev 应用举例
相关项目可以从 yibie/awesome-jev 和 logicrw/awesome-jev-projects 这两份清单里找。下面挑几个例子,结合 README 和部分源码看看它们怎么用 Jev。
其中有些项目还处于实验或 MVP 阶段,可以参考实现思路,实际效果和适用范围在下面分别说明。
浏览器:让 Jev 选控件,让生成模型填文字
Browser Use 的 Jev Ultrafast是一个很直观的例子。程序先把页面整理成编号控件列表,例如“1 号是单程按钮,2 号是出发地输入框,3 号是目的地输入框”。Jev 选择操作及目标,浏览器代码负责执行。
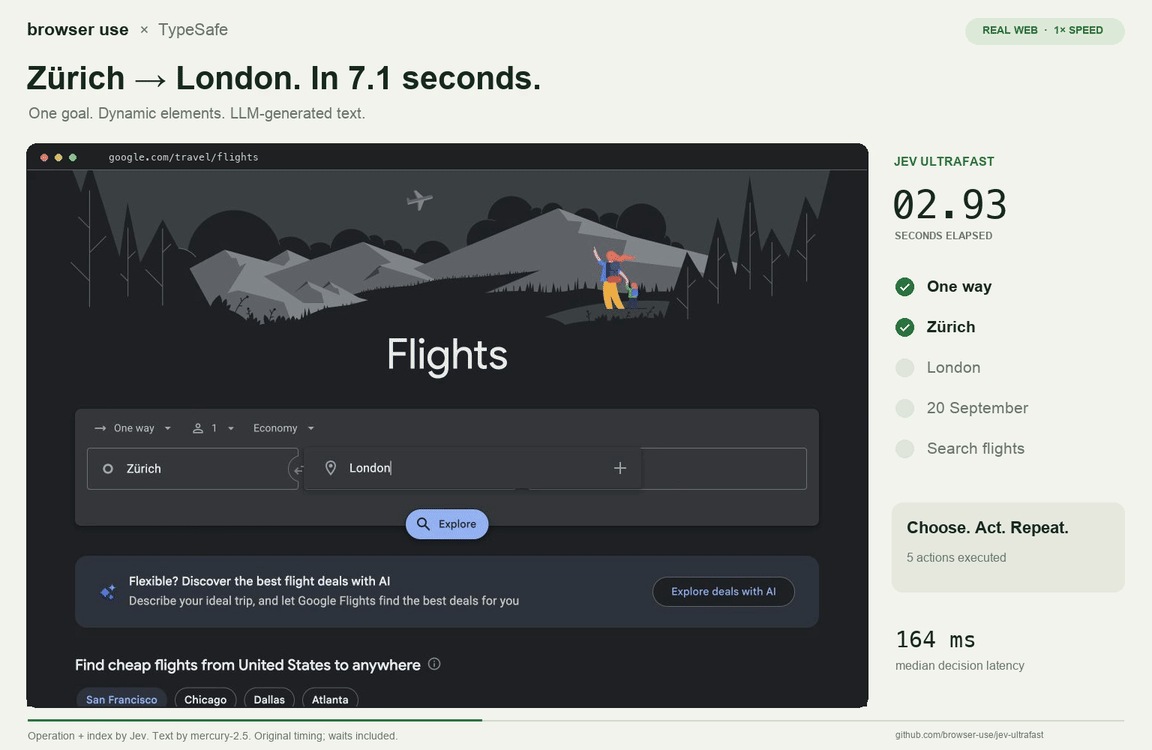
图:项目航班查询演示中的一个中间状态,来源:Jev Ultrafast。截图里的计时与延迟来自项目演示,本文未独立复现。
当操作是 TYPE_TEXT,它再调用小型生成模型填写城市名等开放文本。一次 Jev 请求可以预先询问不同操作对应的目标,代码只取最终操作用得上的那个答案。
项目展示过约 7 秒完成航班查询的演示,计时从初次页面观察之后开始,包含模型、生成文本、浏览器操作与等待;它不包含完整冷启动。这不意味着“所有网页任务只要 7 秒”。这个演示只查询航班,不涉及购票。模型返回 DONE 后,也还需要检查航线、日期和结果页。
默认循环消费的是 DOM 整理出的结构化状态,并非 Jev 直接看截图。iframe、shadow root、canvas、上传、多标签弹窗等也不能因为演示顺畅就假定已经覆盖。
Coding Agent:风险判断可以拆开问
jev-guard在工具执行前后增加模型辅助检查。执行前分别问:这个操作有什么风险?用户真的授权了吗?有没有被网页或文件里夹带的指令影响?执行后,再检查返回内容里的提示注入。
这比单独问一句“安全吗”更容易写策略。例如,“操作本身可逆”和“操作由用户要求”是两回事;“用户要求过类似工作”也不代表可以忽略当前操作的影响范围。
但模型只是门禁的一个输入。此前源码核对发现,该项目的默认 API 故障策略会放行,部分宿主也不能完整实现人工确认。真要用在高风险路径上,必须检查超时、截断、跳过检查和失败回退的行为。它不能替代沙箱、最小权限或操作授权。
另一个小工具 pkg-gate会检查 npm 的 preinstall、install、postinstall 脚本,把判断汇总为 allow/warn/block。其实现有本地 simulator 和 mock 路径:终端上出现概率,并不自动证明调用了真实 Jev。它检查收到的脚本文本,也不代表已经审计整个依赖树和脚本下载的内容。
RAG:相关,不等于能当证据
jev-reranker接在检索后、生成答案前,判断候选文档的相关性或证据价值,再排序、过滤。
例如,要回答“某版本是否修复了这个漏洞”,一篇反复出现产品名的介绍文章可能高度相关,却不能证明漏洞已经修复。针对版本的发布说明或修复提交,才可能提供有效证据。
这里分工比较清楚:搜索负责找候选,Jev 判断哪些材料值得送进上下文,生成模型负责组织答案。如果没有文档通过阈值,可以重新搜索、补充信息,或者暂时不回答。硬塞几篇进去,也可能把后面的回答带偏。
这里的阈值要用自己的问题和文档验证。top-k 如果发生在评分之后,并不会减少已经做完的评分工作。
文档处理:OCR 取文字,Jev 判断边界
DocJev处理的是另一类常见麻烦:一份扫描 PDF 里混着合同、发票和说明函,要把它们分类,并按连续页段拆开。
按项目说明,它先用 LiteParse 或可选 LlamaParse 获取页面内容,再让 Jev 判断类别和文档边界,最后由代码导出 PDF。这里没有“模型直接看着 PDF 就全懂了”:解析、OCR、语义判断、文件操作是不同步骤。
项目提供了 API、CLI 和评估材料;本文对这一部分主要核对 README,没有独立复现。尤其需要注意,本地解析不代表全程离线,提取后的文字仍可能被发送给托管决策服务。含客户资料的文件需要先确认数据处理要求。
技能路由:接上了,不一定省下了
jev-skill-router会为 Claude Code 推荐技能:先看用户输入和技能清单缩小候选,再读候选的完整 SKILL.md,最多推荐一个。
作者保留了一个很有用的提醒:普通 UserPromptSubmit hook 无法删掉主模型原本看到的技能列表。因此,即便 Jev 已经选过一次,主模型仍然会看到那份列表,相关 token 并没有自动消失。默认 shadow 只记日志,启用 inject 才追加建议。
这适合作为路由实验参考,却不能直接写成“装上就给 Coding Agent 降本”。只有当前一句输入时,连续追问也容易被当作新任务。接入点和输入上下文,往往比模型报价更决定收益。
0x05 游戏里的 Jev
除了上面这些工具,游戏类项目也挺有意思的。不过看演示之前,得先弄清楚模型到底拿到了什么输入。
前面提到,Jev 只接受文本。官方 Doom 演示也一样,先把游戏状态整理成文字化的数据结构,再交给 Jev 选择动作。屏幕画面是给观众看的。
jev-plays-pokemon则把这个分工写得很清楚:PyBoy 运行《宝可梦 红》,程序读取 RAM、碰撞地图和对话 tilemap,整理位置、队伍、背包、附近对象及历史,然后交给 Jev 选择目标。寻路、按键和防止反复撞墙的逻辑留在程序里。
项目当时自述,开场到取得初始宝可梦的流程较可靠,但首场劲敌战和一般战斗仍不稳定,不能把它写成已经自主通关。
再放几个例子,看看不同游戏是怎么准备状态和动作的:
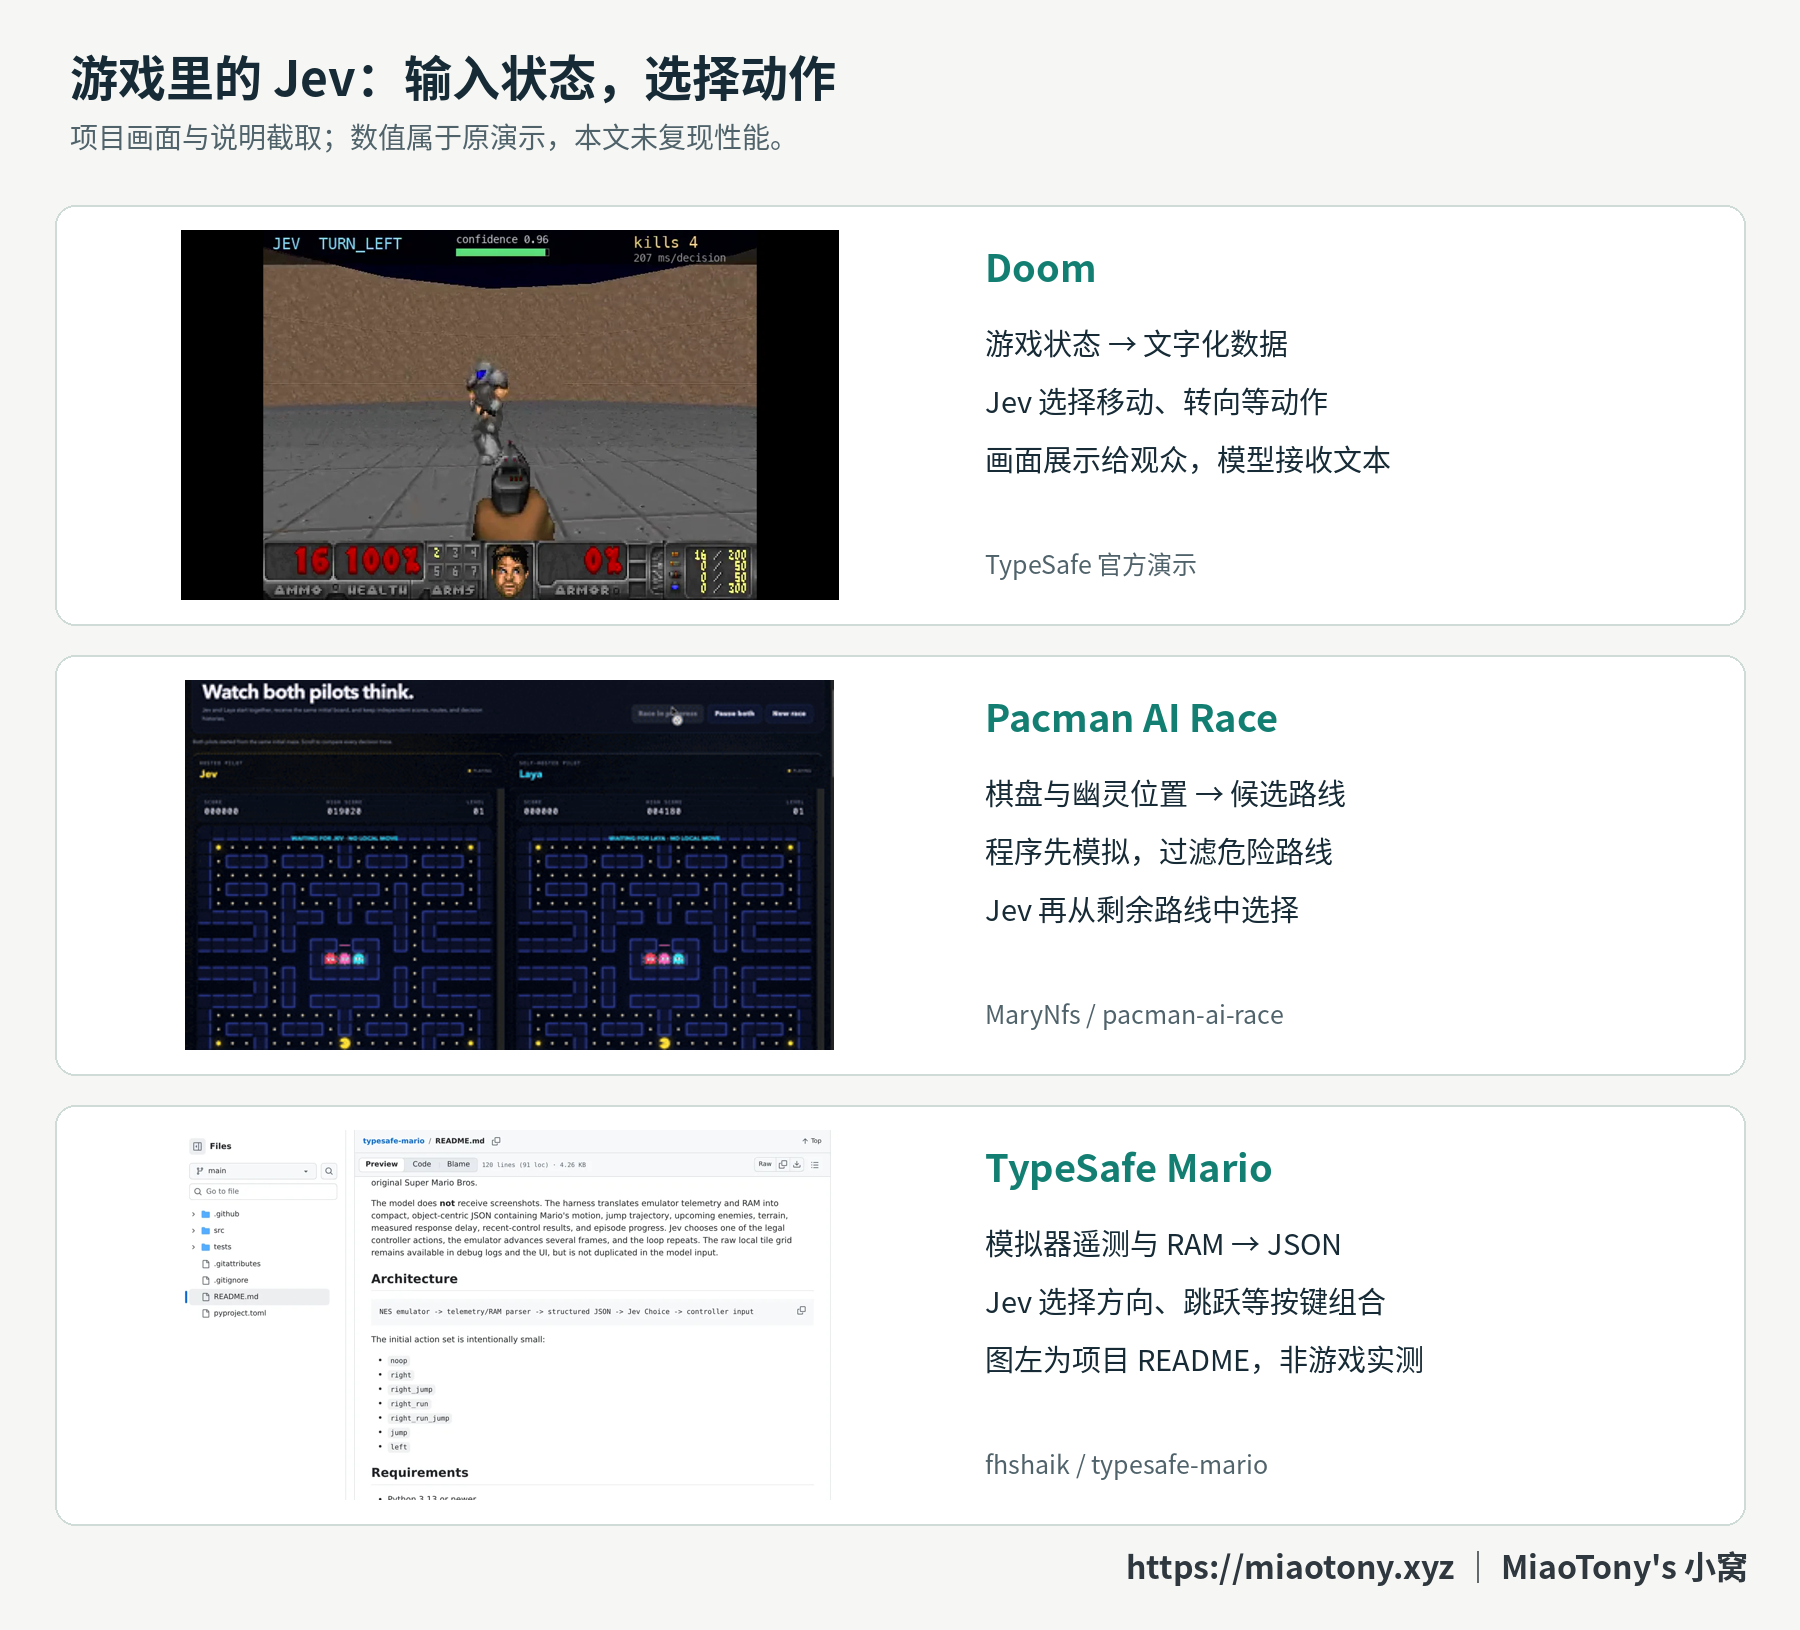
图:Doom 使用官方演示画面,Pacman 使用项目演示截图,Mario 使用项目 README 截图;图中的性能数值沿用原演示,本文未独立复现。
Pacman AI Race会先根据棋盘、幽灵位置和运动规则模拟候选路线,有存活路线时过滤预计致命的路线,再交给 Jev 选择。它还可以让本地 Laya 在同一套游戏规则下并排运行,方便比较。
TypeSafe Mario则把马里奥的位置、速度、跳跃状态、敌人和地形等信息整理成 JSON,让 Jev 选择向右、跳跃、向右跑跳等按键组合。时间和轨迹计算留在代码里,Jev 根据整理好的状态做判断。这个项目仍属于实验性控制器。
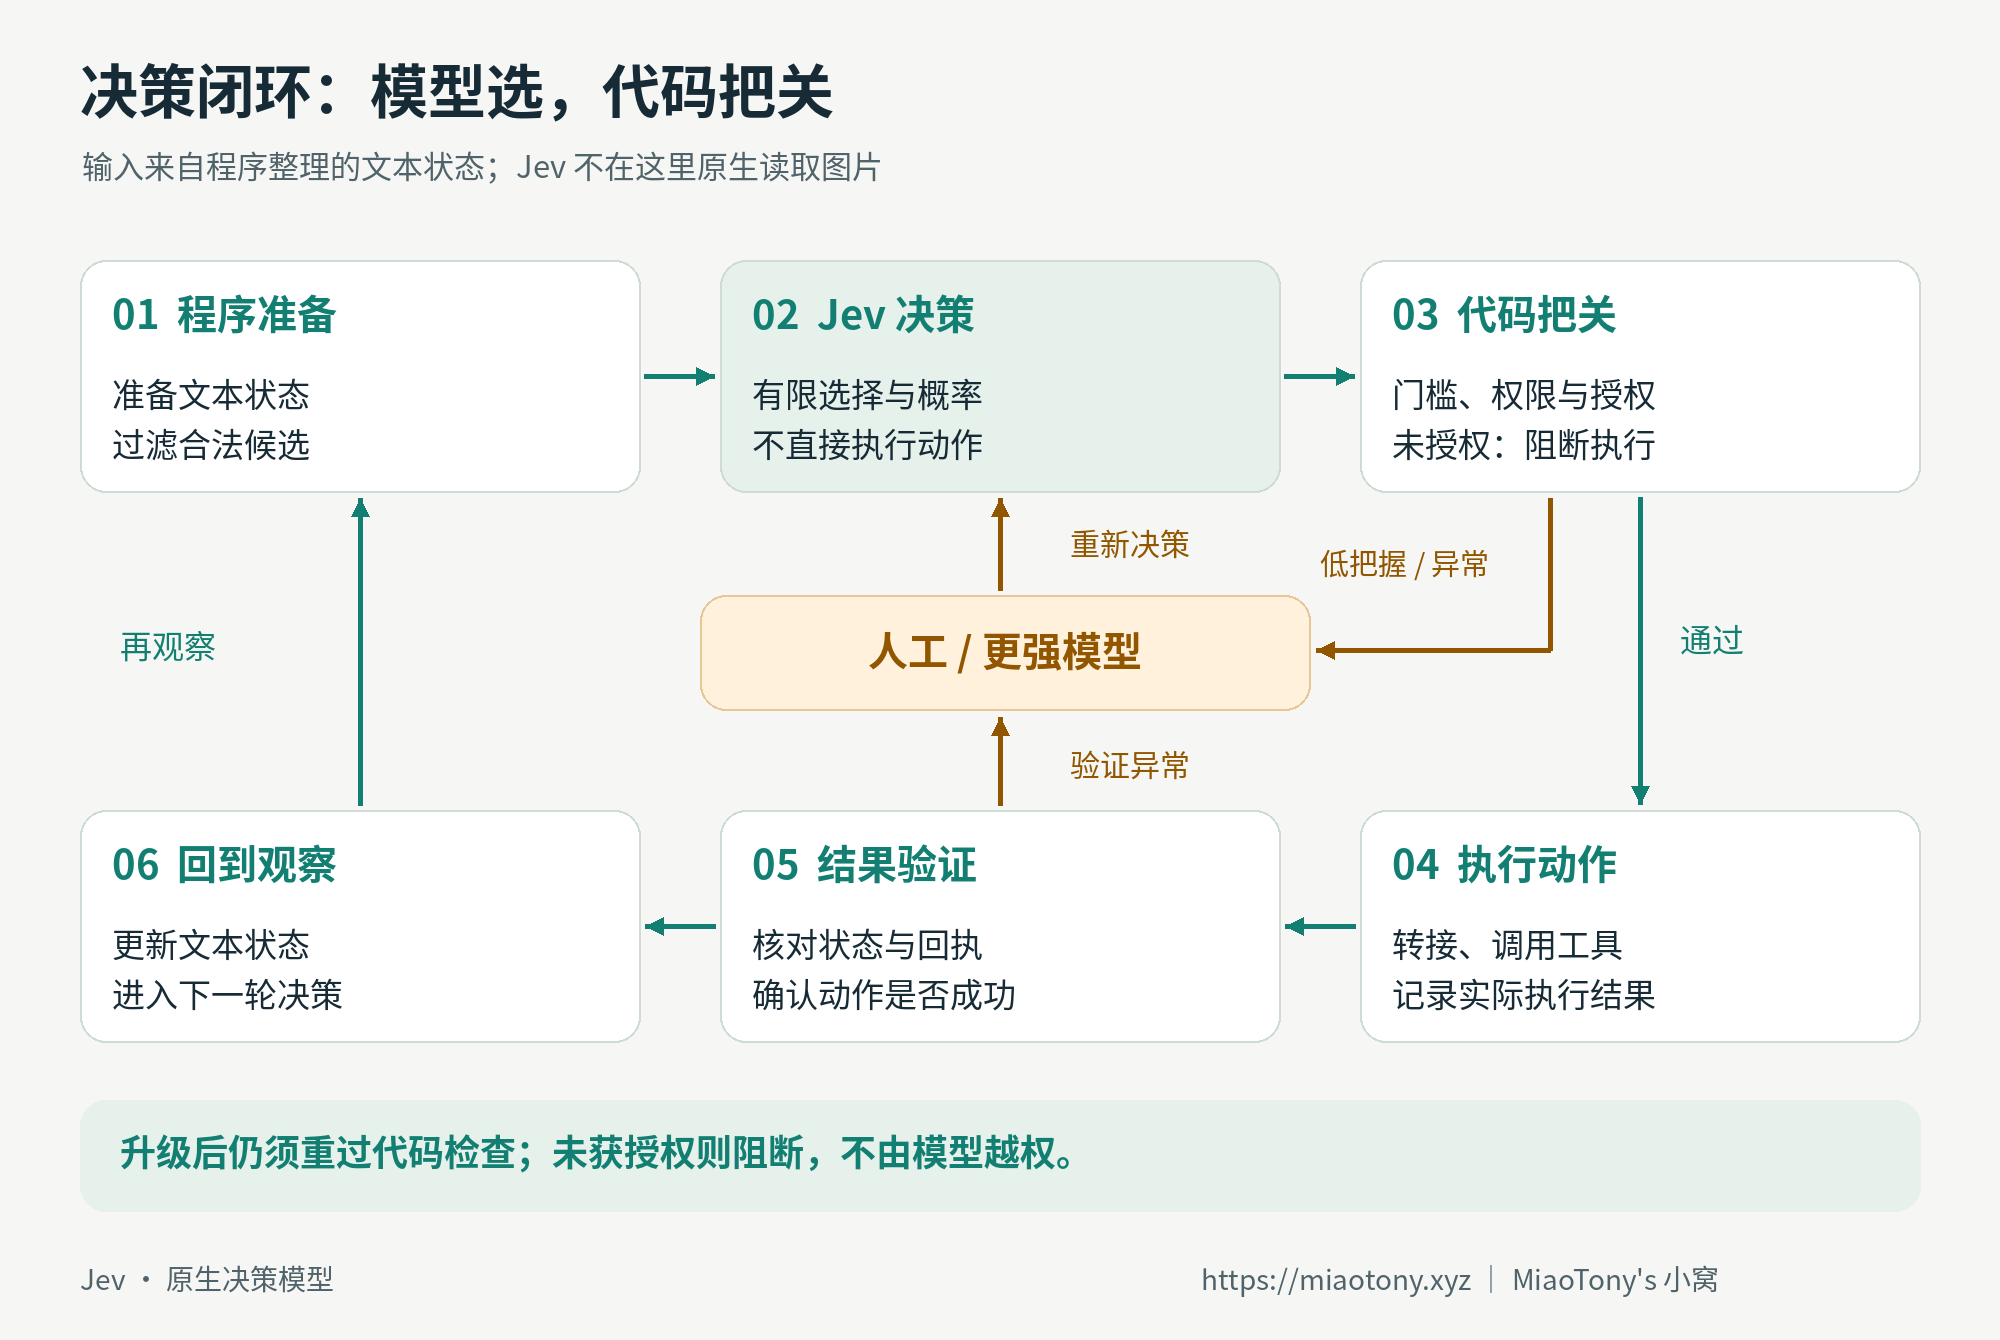
图:浏览器、游戏和工具路由可以共享这种分工。不确定的判断不该直接变成高风险动作,异常与低把握结果需要明确的复核路径。
cablehead 的 2048 实验提供了一个很好的反例:只给棋盘时,Jev 的表现接近随机;外围代码先算好动作后果,再让它从中选择,效果才接近固定启发式规则。
所以,“模型选了左边”只是其中一步,状态提取、候选准备和动作执行同样会影响结果。现成规则或搜索算法能处理好的部分,可以先保留下来,再比较接入模型后有没有改善。
0x06 类型安全、概率与使用限制
官方宣传里提到了“不会产生幻觉”,这个说法容易让人误会。结合文档来看,它保证的是:输出满足给定的类型和答案空间。
你只允许“售后”“财务”“人工复核”,模型不会随意返回一个新部门名。但它仍然可能把退款问题分给错误的队列。
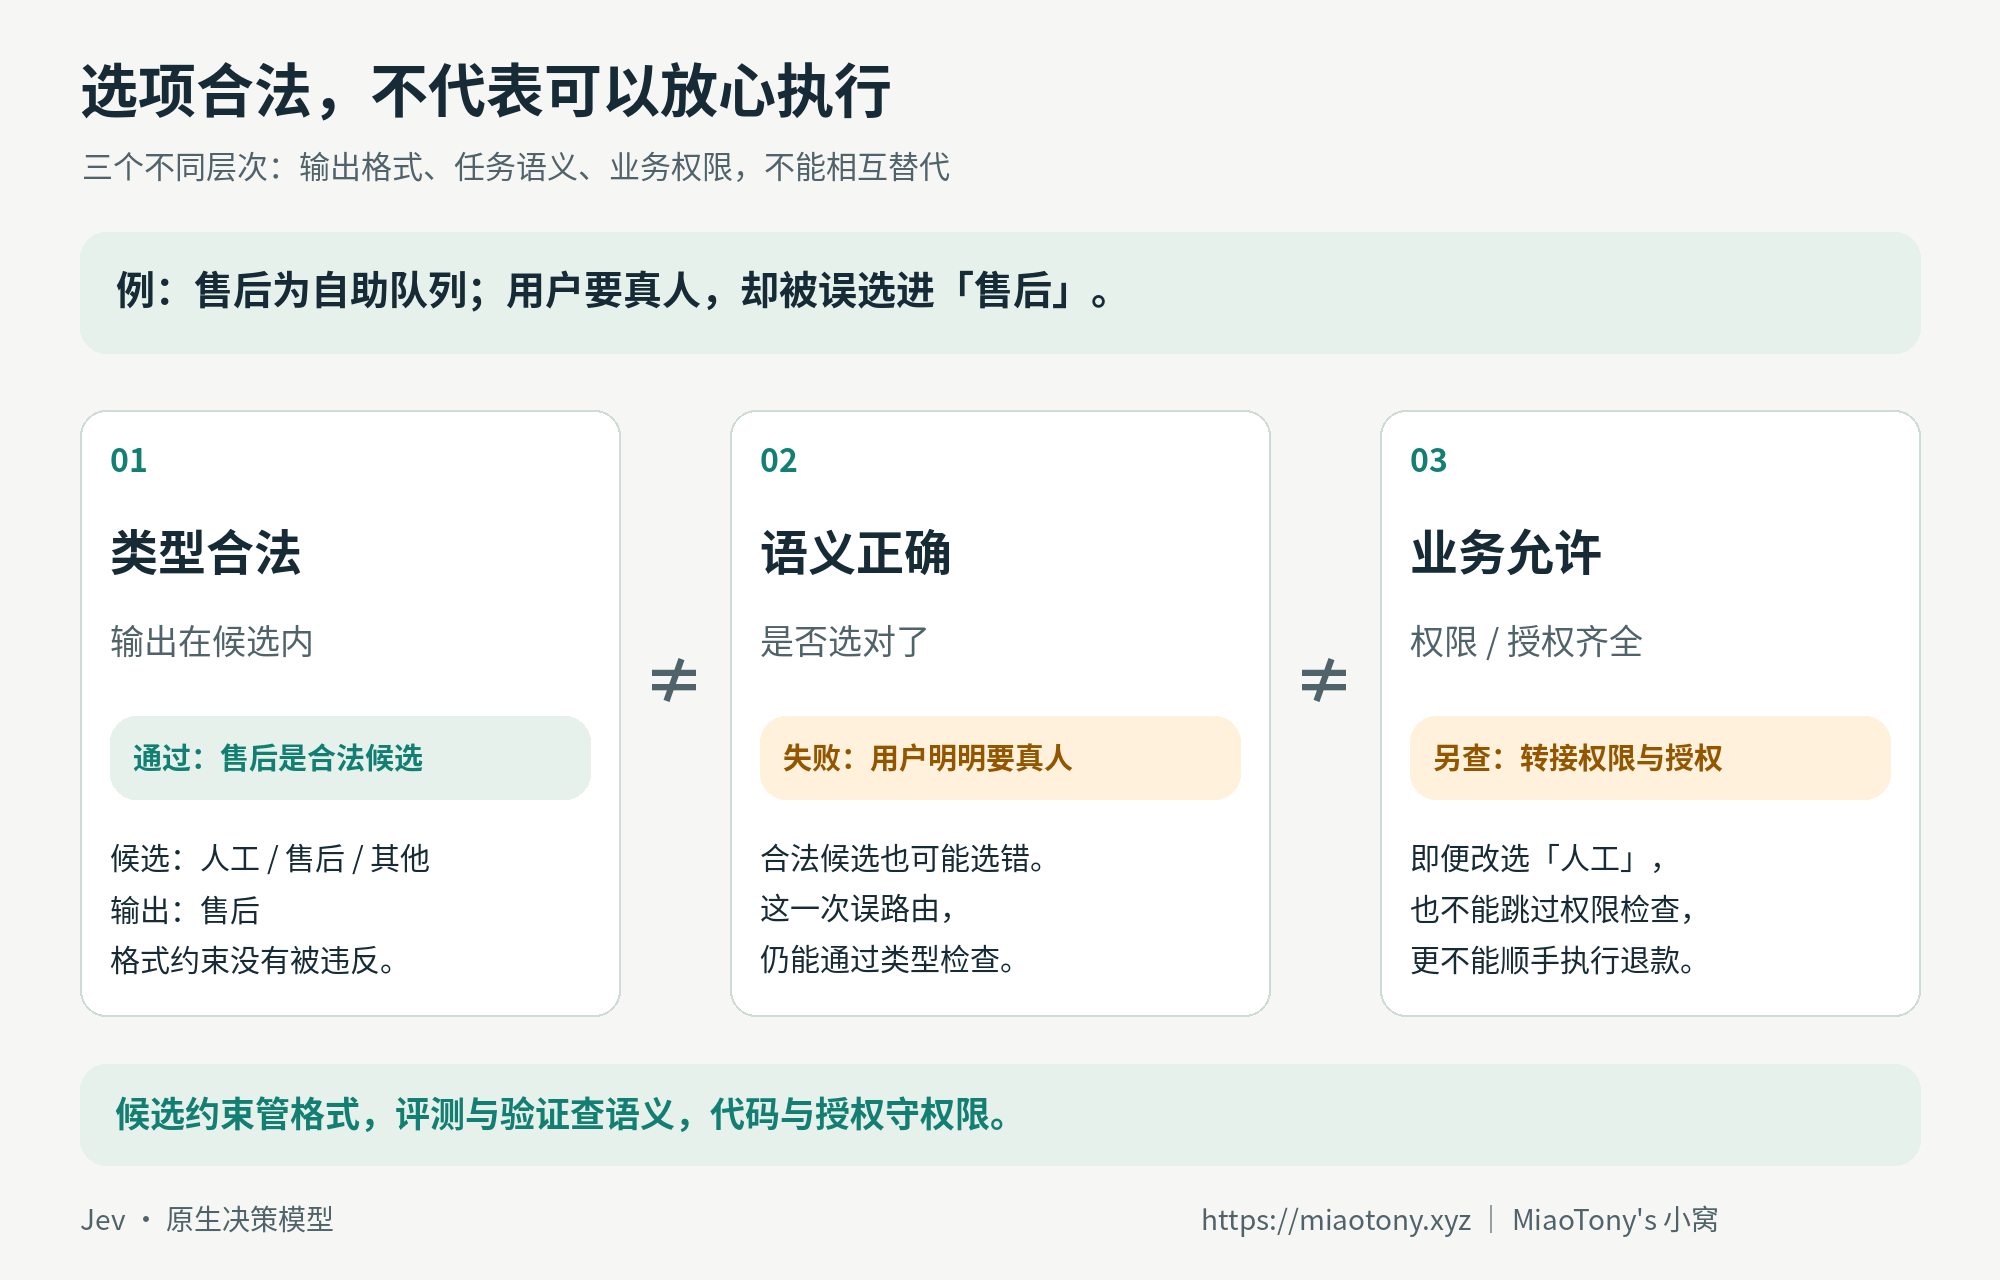
图:返回值能被程序读取,只解决了格式层的问题。正确性和执行权限要另外判断。
官方发布文也说明,评测图里的 0% 是根据 schema 保证填入的类型错误率,没有经过大规模事实问答实验来验证“零错误”。用的时候还是需要区分这两件事。
概率和 confidence
校准讨论的是一批预测。例如,在一组可比样本里,模型给出约 0.8 概率的事件,实际发生比例是否也接近 0.8。它不能保证眼前这一次就正确,也不能保证换成中文、新领域或新提示之后仍然同样可靠。
Confidence 文档还有一个重要细节:Choice 和 Score 的 confidence 由已有概率分布计算得到,不能直接理解为“本次答案正确率”。分布很集中,模型也可能很自信地选错。
目前官方已经公开了计算公式。对有 n 个候选的 Choice,confidence = (p_max - 1/n) / (1 - 1/n)。例如三个候选的最高概率为 0.9,返回的 confidence 是 0.85,和最高概率 0.9 有区别。Score 则还考虑等级之间的距离,不能直接套 Choice 的公式。
不同问题并行求值,也不代表它们统计独立。分别询问命题 A 及其否定命题,结果不保证严格互补;把同一个业务问题从 Noul 改成 Choice 后,原来的阈值也不应不经测试就沿用。
官方自己列出的薄弱环节
已知缺陷页比宣传口号更值得在上线前读一遍:
- 精确计数、算术和日期比较不可靠,这些交给代码。
- 多层间接推理、双重否定和矛盾指令可能影响效果。
- 无关内容塞进
state会干扰判断;支持较长输入不等于应该塞满。 - 对抗性文本和提示注入仍然可以改变输出。
尤其是最后一点:可以用 Jev 辅助识别提示注入,不等于它自己对提示注入免疫。候选即使个个符合 schema,其中也可能有不该执行的动作。
0x07 接入时有什么需要注意的地方
一个比较稳妥的起点,是频率高、答案范围有限、允许复核的语义判断。先让 Jev 在影子模式里给结果,业务仍走原流程,再比较差异。
候选先过硬规则
权限、签名、金额上限和日期条件能确定计算,就在代码里处理。不要把“当前用户是否有删除权限”变成一道模型语义题。对于 Agent,只把当前确实可执行的候选提供给模型,并在实际执行前重新校验,防止状态已经变化。
一次请求的实际长相
原生接口是 POST https://api.typesafe.ai/v1/systemone,使用 Bearer API Key 鉴权。按官方 API的格式,前面那张工单可以这样组织请求。下面仅演示请求结构,未实际调用:
{
  "model": "jev-1.13.0",
  "state": "我已经问了三次,能找个真人吗?",
  "questions": {
    "queue": {
      "type": "choice",
      "instructions": "根据工单内容,选择下一步应进入的处理队列。",
      "criteria": {
        "human": "明确要求真人介入的人工客服队列",
        "support": "常规售后处理队列",
        "other": "信息不足或不属于上述情况"
      }
    },
    "urgency": {
      "type": "score",
      "instructions": "依据客户表达的诉求评估跟进优先级。",
      "criteria": [
        "普通咨询,可以排队处理",
        "重复追问或问题拖延,需要优先跟进",
        "明确升级诉求,需要尽快人工处理"
      ]
    },
    "needs_human": {
      "type": "noul",
      "instructions": "客户是否明确要求真人客服?",
      "criteria": {
        "true": "明确提出需要真人或人工接手",
        "false": "没有提出真人或人工接手的要求"
      }
    }
  }
}
响应通过 answers.queue、answers.urgency 和 answers.needs_human 对应这些问题。Choice 的 criteria 是候选名称到描述的映射,Score 的 criteria 是等级数组,Noul 的 criteria 描述“是”和“否”的含义。
有两个容易写错的细节:questions 使用对象结构,以问题 ID 为键;needs_human 这样的问题 ID 不进入模型推断,判断条件必须写进 instructions,不能只靠变量名暗示。输出免费也不意味着响应里的 usage.output_tokens 必须为零。
分数后面要有明确的策略
拿到 Noul 概率之后,可以用代码决定后面怎么处理,比如下面这样。阈值只是教学示例,实际使用需要自行测试;代码只返回队列名称,不执行外部动作。
import math


def human_request_policy(p):
    """教学示例:p 为 Noul 返回的“明确要求人工”的概率。"""
    if isinstance(p, bool) or not isinstance(p, (int, float)):
        return "review"
    if not math.isfinite(p) or not 0 <= p <= 1:
        return "review"
    if p >= 0.90:
        return "human_queue"
    if p <= 0.10:
        return "normal_queue"
    return "review"


assert human_request_policy(0.99) == "human_queue"
assert human_request_policy(0.02) == "normal_queue"
assert human_request_policy(0.50) == "review"
assert human_request_policy(float("nan")) == "review"
assert human_request_policy(None) == "review"
“没有明确要求人工”不代表“所有其他风险都正常”。一个客户没有说“找真人”,仍可能描述紧急故障;队列选择还要结合其他问题和业务规则。接口超时、网络故障或响应解析失败,应在调用层进入明确的异常路径,不要伪造一个 0.0 继续跑。
如果多个问题会共同决定高风险动作,最好再加互相冲突时的处理规则。不要把几项概率直接相乘,声称那就是执行安全率。
算完整任务的账
上线前至少对比规则基线、原有模型方案和 Jev 方案,使用同一批真实任务。除了总体正确率,还要看危险误放、误报、人工复核比例、P95 延迟、重试和完整任务费用。
特别留意那些看起来“省 token”却破坏了主模型缓存、增加了额外轮次的方案。Codex Jev Router就是一个提醒:虽然名字还含 Jev,查阅时的推荐路径已经转向本地确定性的证据筛选,旧模型路由仅保留用于复现。
版本、提示、候选和阈值应该一起记录。升级模型或换一种提问方式后需要重新评估,只更新别名可能会漏掉行为变化。中文任务也要有自己的测试样本,不能直接套用英文演示的结论。
0x08 最新的动向:Decisions API 与开源替代
前面都在说 Jev 本身,收尾前补一下最近的相关动态(截至 2026 年 10 月初)。
OpenAI 在 DevDay 2026 上发布了 Decisions API。按官方说明,它把 GPT-6 Luna 用在开发者定义的有限答案问题上,用来分类内容、路由请求或选择 Agent 的下一步动作;上下文支持文本和图片,后面这点和只收文本的 Jev 有明显差别。发布时处于 limited preview,请求格式、返回字段和定价当时都还没有公开,等正式文档出来再做详细对比会更准确。
Keynote 演示里,Decisions API 驱动的 computer-use agent 操作流畅了不少。OpenAI 自己的幻灯片称单次决策约 150 毫秒,对照同一模型的标准调用约 1.6 秒;这个基线是 OpenAI 自家模型,数字也来自发布会演示,细节可以再看第三方的整理。
Jev 发布两周后就出现了同类的 API,至少说明「把小判断从生成模型里拆出来」这个方向被更多团队认可,后面的比选和价格战应该还会更热闹。
Jev 模型本身没有开源。 可公开取得的官方 Python SDK等工具链,与 Jev 的权重和训练实现是两件事。System One Adapter使用其他 LLM API 来提供兼容接口,运行时仍然依赖对应的 LLM 服务。
开源这边也有不少尝试,DataCamp 做过一轮对比:
- Laya:专门为决策训练的非自回归模型,参数量 322M–421M,有英文和多语言 checkpoint,支持
choice、score、noul;社区还有配套的 ONNX 运行包,可以本地甚至 in 浏览器运行。 - Kev:基于 Qwen3.5 的 0.8B / 4B / 9B 系列,加了 LoRA 和指针头,服务端实现了 TypeSafe 的
/v1/systemone接口,TypeSafe SDK 的代码可以直接指向本地 Kev 服务。 - Nimble:用 Qwen3.5-9B 加 LoRA 微调,按 boolean / enum schema 返回选项和概率,训练配方和数据管线也都开放了。
这些项目接口兼容、权重开放,方便本地部署和研究;效果和校准是否接近 Jev,还是要拿自己的任务实测,本文没有做这部分横向对比。
从前面的例子来看,Jev 比较适合处理需要理解语言、答案范围又比较明确的任务。比如邮件分流、搜索结果筛选,或者从一组合法动作里选择 Agent 的下一步。需要生成文本或做复杂推理时,再配合其他模型使用。
如果想试试,建议先挑一个容易评估、出错可回退的小任务,对比一下规则、原有模型和 Jev 的效果。能省多少时间和费用,还是要放到自己的使用场景里看。
相关项目和资料链接都放在文中了,感兴趣的话可以接着翻翻。
0x09 小结
这篇主要整理了 Jev 的三种接口,以及它在 Agent、RAG、文档处理和游戏里的用法。Choice 负责从候选里选择,Score 按定义好的等级打分,Noul 返回“是”的概率,后面的处理流程由代码来接。
看完这些例子,比较适合拿来尝试的还是分类、筛选和路由这类小任务。模型能省去多少时间和费用,需要和现有方案放在一起测试;状态怎么准备、候选怎么列、出错以后怎么处理,也都会影响最终效果。另外,OpenAI 的 Decisions API 和一批开源替代的出现,也说明这类决策接口正在被更多团队跟进。
另外,类型安全只保证输出形式符合要求,选对答案还得靠评测和验证。把这点分清楚,再结合自己的需求选一个小场景试试,就比较容易判断 Jev 到底能帮上什么忙了。
0xFF 参考资料
官方文档与说明
- TypeSafe AI:Introducing System One Models & Jev
- API Reference
- Choice、Score、Noul
- 模型、价格与上下文限制
- Confidence 与 System One 概念说明
- Jev 1.13 已知缺陷
- TypeSafe 官方工作流评测
动态与开源替代
- OpenAI DevDay 2026 Recap
- OpenAI’s Decisions API vs Jev(第三方整理)
- DataCamp:Top Open-Source Jev Alternatives
访谈、项目与实验
- Latent Space:与 TypeSafe 创建者 Diogo Almeida 的访谈
- Simon Willison:Jev
- Awesome Jev 与 Awesome Jev Projects 中文目录
- Jev Ultrafast、jev-guard、pkg-gate
- jev-reranker、DocJev、jev-skill-router
- jev-plays-pokemon 与 2048 实验记录
项目截图的来源见图注。视频与图文分工不同,API 字段、模型版本和限制请以本文链接的文档为准。